VECAI INDUSTRY RESEARCH / CPU2026年9月30日 · 产业专题研究

智能体扩大执行需求,CPU供需保持紧平衡

个人智能体、企业任务、AI科研与后训练需要云端CPU反复运行工具,GPU系统也需要机头CPU提供数据与调度。基准情景预计2030年全球服务器CPU年度采购需求5,020万颗、有效交付4,708万颗,供需覆盖率93.8%。这是一组以2025年拟合基点、任务活动和芯片供应路径构建的预测。

2030年基准需求 · 年采购5,020万颗CPU

传统业务、GPU机头和机头之外的AI工作互斥相加。

2030年基准有效交付 · 年4,708万颗CPU

芯片和配套交付另接受先进晶圆可分配量检验。

2030年基准AI相关需求 · 年采购2,234万颗CPU

GPU机头与机头之外AI工作合计,约占总需求44%。

01
CPU SUPPLY & DEMAND

服务器CPU已现紧张,基准情景2030年覆盖率93.8%

英特尔披露服务器CPU需求超过可供货量,行业交期一度显著拉长。下图将七类年度采购需求与芯片有效交付逐年比较。

全球服务器CPU供需 · 2025—2030年切换情景,比较需求强度与供应兑现

基准情景:2030年需求5,020万颗,交付4,708万颗

年度需求高出有效交付312万颗,供需覆盖率93.8%。

需求包含传统服务器、GPU机头、个人与企业智能体、AI科研、后训练强化学习和其他AI负载七类。个人智能体的高峰并发与AI科研任务的长时间高负载,限制了简单依靠池化提高使用率的空间。

有效交付由服务器CPU芯片生产与配套能力形成,同时接受先进晶圆分配检验。英特尔供货不足和交期是当前景气的直接证据;2027年以后新工艺逐步爬坡,需求与供给的相对速度决定缺口是否收敛。

全球服务器CPU供需与覆盖率:基准情景

柱:年度需求和有效交付;折线:供给÷需求,100%为平衡

年度采购需求有效交付供需覆盖率
悬浮或点选查看;键盘可逐期查阅
全球服务器CPU供需与覆盖率:基准情景;左轴:百万颗服务器CPU / 年;右轴:供需覆盖率(%)
期间年度采购需求有效交付供需覆盖率
2025基准25.0225100%
2026E30.012790%
2027E35.4230.2485%
2028E39.5536.8993%
2029E44.5142.896%
2030E50.247.0894%

2025年为按服务器CPU销量拟合的供需比较基点,2026—2030年为研究情景。有效交付取芯片制造与配套交付能力、扣除GPU和专用芯片占用后的先进晶圆能力两者较低值。

查看图表数据
全球服务器CPU供需与覆盖率:基准情景;柱/左轴:百万颗服务器CPU / 年;折线/右轴:供需覆盖率(%)
时期 / 项目年度采购需求有效交付供需覆盖率
2025基准25.022599.9%
2026E30.012790.0%
2027E35.4230.2485.4%
2028E39.5536.8993.3%
2029E44.5142.896.1%
2030E50.247.0893.8%
全球服务器CPU年度供需;2025年拟合基点,2026—2030年研究情景,单位:万颗/年
年份需求有效交付差额
需求−交付
供需覆盖率
交付÷需求
2025基准2,5022,500+299.9%
2026E3,0012,700+30190.0%
2027E3,5423,024+51885.4%
2028E3,9553,689+26693.3%
2029E4,4514,280+17296.1%
2030E5,0204,708+31293.8%

全球服务器CPU年度供需 单位:万颗/年

2025基准供需覆盖率 99.9%

需求2,502

有效交付2,500

需求−交付+2

2026E供需覆盖率 90.0%

需求3,001

有效交付2,700

需求−交付+301

2027E供需覆盖率 85.4%

需求3,542

有效交付3,024

需求−交付+518

2028E供需覆盖率 93.3%

需求3,955

有效交付3,689

需求−交付+266

2029E供需覆盖率 96.1%

需求4,451

有效交付4,280

需求−交付+172

2030E供需覆盖率 93.8%

需求5,020

有效交付4,708

需求−交付+312

2025年为拟合基点;2026—2030年为研究情景。覆盖率=有效交付÷需求。

芯片及配套交付年增速的研究假设:2026年8.0%、2027年12.0%、2028年22.0%、2029年16.0%、2030年10.0%。公开资料支持当前缺货及新产能逐步释放的方向,具体增速仍需用产品量产和交期核验。

需求增长、核心数升级与2026年涨价共同扩大服务器CPU市场

2025年芯片市场起点约292亿美元;基准情景2030年潜在需求收入约1377亿美元。

2025年以约2502万颗服务器CPU、约1167美元加权均价,得到约292亿美元芯片市场起点。Mercury Research披露的2025年AMD EPYC和英特尔至强可扩展处理器均价分别约为1,325和1,125美元;其他架构与高端产品售价采用研究估计。图中收入是芯片层口径,并非两家公司数据中心业务收入之和。

售价分成三层:传统服务器、GPU机头、独立执行池和其他AI负载各有2025年基价;核心数增加时,价格按核心数约0.75次方变化;高端配置占比提升和同规格成交价变化另计。同规格成交价指数以2025年为100,2026年设108,2027年设110,到2030年为103。该指数是市场整体研究假设,避免把部分型号的涨幅当成全行业成交均价。

英特尔2026年上半年服务器CPU均价同比提高约38%,主要来自高端产品组合;TrendForce观察到部分服务器CPU从3月起报价上调10%—20%,并报道AMD后续两轮涨价计划。路透社采访中,中国市场部分型号年初至7月涨价超过40%。这些证据支持供需紧张下的成交价上行,但覆盖产品和口径不同。模型算得2026年加权均价约1472美元,芯片潜在需求收入约442亿美元;若不计同规格成交价上调,同样采购量对应约409亿美元。到2030年加权均价约2744美元,可交付芯片收入约1292亿美元。AMD提出的2030年服务器CPU可服务市场超过2,000亿美元是公司机会判断,与本图口径不同。

2025—2030年服务器CPU芯片市场空间

柱为年度芯片收入,折线为需求组合加权平均售价

潜在需求收入可交付收入(同组合)需求组合平均售价
悬浮或点选查看;键盘可逐期查阅
2025—2030年服务器CPU芯片市场空间;左轴:亿美元 / 年;右轴:美元 / 颗
期间潜在需求收入可交付收入(同组合)需求组合平均售价
2025292.1291.81,167
2026441.9397.51,472
2027617526.71,742
2028808753.72,043
20291,057.91,017.12,377
20301,377.21,291.62,744

芯片层市场空间=各类年度采购颗数×相应平均售价,未包含整机、内存或云服务收入。价格分别计核心密度、产品组合及同规格成交价变化;2025年为研究拟合,2026—2030年为研究情景。可交付收入按同组合与供需覆盖率折算。

查看图表数据
2025—2030年服务器CPU芯片市场空间;柱/左轴:亿美元 / 年;折线/右轴:美元 / 颗
时期 / 项目潜在需求收入可交付收入(同组合)需求组合平均售价
2025292.1291.81,167
2026441.9397.51,472
2027617526.71,742
2028808753.72,043
20291,057.91,017.12,377
20301,377.21,291.62,744
02
CPU FOUNDATION

智能体让CPU从推理配角走向执行资源

对话式AI交付一次回答;智能体多轮运行浏览器、代码和专业软件,使CPU成为任务完成速度的一部分。

从一次回答到反复执行,智能体增加了CPU工作

对话式AI以生成回答为主;智能体还要运行工具、读取结果,必要时多轮重试。

CPU是执行通用程序的中央处理器。GPU适合大规模并行矩阵计算,模型推理主要靠GPU;系统管理、数据准备、代码运行、网页操作和结果校验仍需CPU。智能体从“回答”走向“行动”,增加的是反复执行和验证环节。

同一项任务会在模型规划、CPU执行和结果判断之间循环,新增CPU需求取决于真实工具运行时间与并发规模。工具等待、内存和网络也会影响完成速度。

CPU贯穿模型调用,智能体还会反复执行工具
对话式AI · 一轮问答
用户提问→CPU接入并组织模型请求→GPU推理→CPU整理并返回答案
智能体AI · 多轮完成任务
用户目标→CPU接入、拆解与调度→GPU规划下一步
CPU运行浏览器、代码和工具→CPU读取结果并组织下轮请求

↶ 未完成时,再调用模型判断、执行工具并检查结果

CPU运行通用程序,GPU处理密集并行计算

两类芯片负责不同工作;核心数量不能跨架构直接比较。

CPU擅长快速处理多样的指令,运行操作系统、数据库、浏览器和专业软件;GPU擅长把大量相似计算并行完成,是大模型训练与推理的主力。即使主要成本花在GPU上,CPU供给不足仍可能阻塞数据准备、调度与工具执行。

服务器CPU把多个物理核心、内存控制器和输入输出接口放在同一处理器中。更多核心可以同时处理更多工作,但内存带宽和软件能否并行,同样影响实际吞吐。

两种芯片在同一任务中的分工
中央处理器 · CPU低延迟、通用执行

操作系统、浏览器、代码、数据库、专业软件和任务调度

工作复杂多变,强调快速响应与系统控制
图形处理器 · GPU高吞吐、并行计算

大规模矩阵运算、模型训练和推理

同类计算量大,强调并行吞吐

不同类型核心的数量与性能不能直接比较;实际系统通常同时需要两类芯片。

执行位置决定新增CPU落在终端、企业服务器或云端

浏览器本地执行、用户电脑、企业集群与云端隔离环境的硬件归属不同。

浏览器本地运行的轻工具、用户电脑上的智能体、企业或科研集群,以及云端隔离沙箱,都能承接智能体任务。前两类可能消耗现有终端CPU;后两类若需要扩容或更新,会形成服务器CPU采购。已有服务器的闲置容量承接任务时,不应再算一笔新增采购。

云端沙箱通过网络隔离、资源限制、持久文件和任务编排保护执行环境。它能让任务跨会话继续,却也需要CPU、内存、存储和恢复调度共同工作。

云端智能体如何在隔离环境中执行
任务入口→调度与权限控制分配任务、启动或恢复沙箱
沙箱 A · 运行中浏览器与代码使用 CPU 与内存
沙箱 B · 等待中保存状态暂停后释放执行资源
沙箱 C · 运行中专业软件与测试按任务调度 CPU
共享 CPU 资源池承接正在运行的沙箱
文件与快照存储恢复浏览器、代码和任务状态
模型推理服务沙箱调用 GPU 或专用芯片

工具执行可能比模型推理更耗时

浏览器、代码和外部服务,会拉长智能体从接到任务到交付结果的时间。

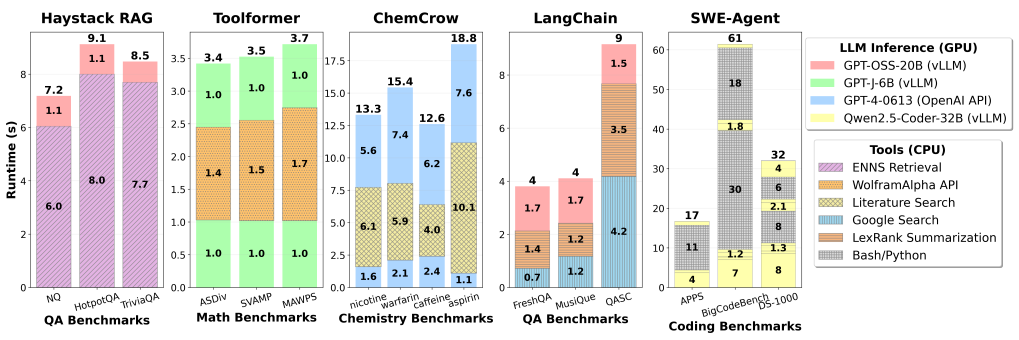
Raj等测试了五类智能体任务,部分任务的工具阶段占总耗时最高约90.6%。这一阶段既有CPU执行,也可能包含网络或外部服务等待。因此,这张图说明工具链的重要性,不能把整段时间都算作CPU满载。

服务商规划系统时,需要一起看模型推理、工具运行与等待;五类测试任务的比例不能代替行业平均值。

五类智能体任务的时间分解研究资料图表 · 点击查看原图
Raj等智能体基准图,分解模型推理与工具调用耗时

Raj等测试:部分任务的工具阶段占端到端延迟最高90.6%,其中也包含外部服务等待。

主机CPU不足会拖慢GPU服务启动

在需要频繁启动模型或处理长上下文的服务中,CPU配置会影响加速器何时开始工作。

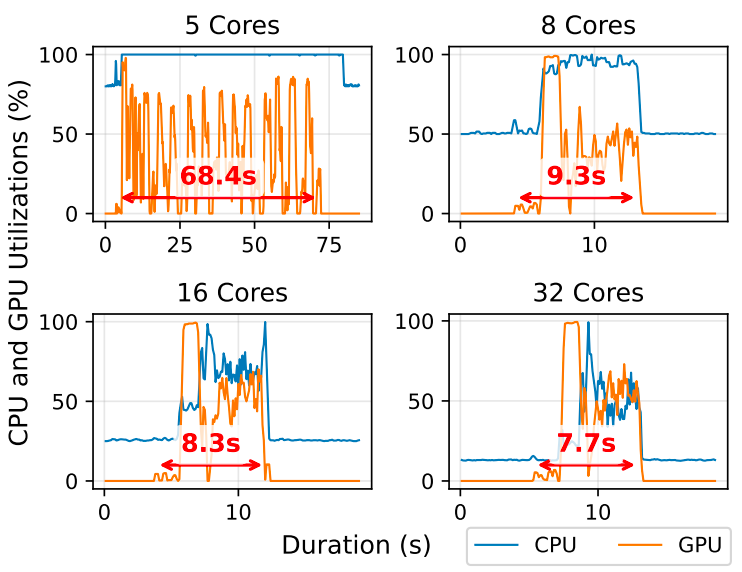
Chung等的多GPU实验保持GPU条件相近,仅将CPU配置从5核提高到32核,模型启动时间由68.4秒降至7.7秒。对需要频繁启动模型和处理长上下文的服务,主机CPU不足会拖慢昂贵的加速器。

这是特定软件栈的启动测试。常驻服务还要考察GPU、内存与网络,CPU核数应按实际流程配置。

固定GPU、增加CPU核数的启动时间测试研究资料图表 · 点击查看原图
Chung等实验中,CPU由5核增至32核时模型启动时间由68.4秒降至7.7秒

Chung等测试:固定GPU配置,增加CPU核数缩短模型启动时间。

长上下文增加主机内存与CPU侧的数据处理

并发对话和智能体保存的中间状态越多,显存之外的缓存管理越重要。

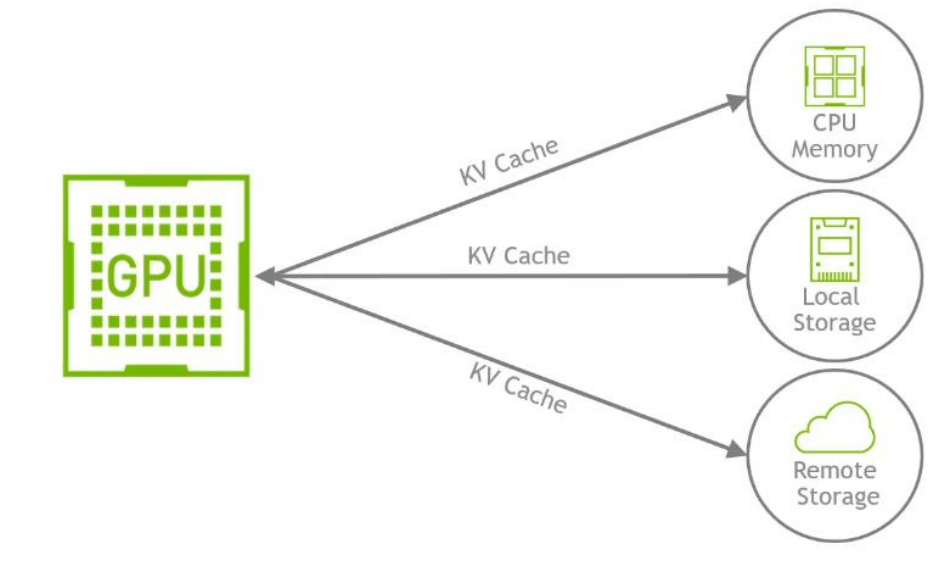
键值缓存保存模型处理过的文本状态。长代码库、多轮任务和多个智能体同时运行,会让缓存随着会话数和上下文长度增加。当GPU显存装不下,服务系统可以把一部分状态放入主机内存或存储;CPU负责主机侧的地址管理、预取、内存访问和向GPU搬运数据。DeepSeek Engram展示了把部分确定性记忆放在CPU侧、再按需预取的做法。

Google TurboQuant通过量化压缩减少每份缓存的占用。若云服务在主机内存侧进行压缩、解压和检索,这些操作也需要CPU参与,更多长会话会增加CPU处理量;若压缩完全在GPU侧运行,就不能把这部分计算记作CPU工作。压缩使单个会话更省内存,与新增CPU计算是同时存在的两种影响。

键值缓存从GPU显存向主机内存卸载研究资料图表 · 点击查看原图
显存、CPU主机内存和存储分层示意

主机侧承接缓存时,CPU要管理寻址、预取、压缩与数据搬运;具体计算可分配到CPU或GPU。

主机内存可扩展模型容量,但会留下吞吐和带宽账单

数据从GPU显存移向CPU侧,收益与代价都要在同一实验里看。

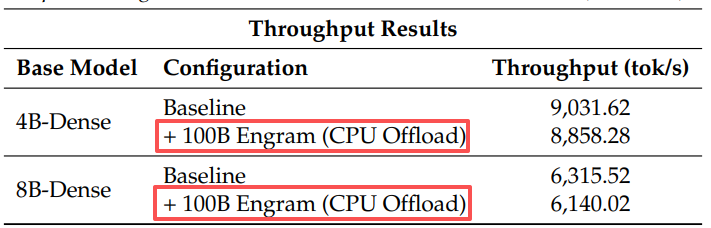
DeepSeek Engram在4B与8B基础模型中加入约100B参数的外置记忆,并将其放在CPU侧。论文的单项吞吐测试显示,4B模型由每秒9,031.62个token降至8,858.28个,8B模型由6,315.52降至6,140.02个,分别下降约1.9%和2.8%。

实验说明主机内存可以承接一部分容量压力,同时带来预取、内存带宽和数据搬运要求。它没有直接披露新增服务器CPU颗数;是否划算还要看内存价格、命中率及服务延迟。

DeepSeek Engram:主机内存卸载的吞吐测试研究资料图表 · 点击查看原图
DeepSeek Engram论文的4B和8B模型加入100B外置记忆后的每秒token吞吐对比

论文测试中,4B与8B模型加入100B外置记忆后,吞吐分别约低1.9%和2.8%。

03
DEMAND DRIVERS

个人、企业、AI科研和后训练带来新的CPU任务

从OpenAI dots、Meta Muse的云电脑到多智能体科研,任务开始跨会话反复执行;芯片采购仍取决于真正运行的任务和每项核时。

OpenAI dots把个人智能体带入常驻工作状态

一个智能体可以保留云电脑和浏览器,按计划继续办事,并把复杂目标拆给子智能体。

OpenAI于2026年9月推出dots,官方说明每个dot有自己的云电脑和浏览器,可运行周期任务,使用连接的工具,并通过ChatGPT、短信、邮件和Slack继续跟进;复杂工作还可能委派给多个子智能体。一次委托因此可能跨越数天、多次执行,而非一次模型回答。

云电脑保存状态时不需要持续满载,但浏览器操作、文件处理、代码运行及并行子任务会反复占用CPU。产品处于逐步开放阶段,不能据此直接推算已部署数量;其意义在于个人智能体开始具备持续工作的执行形态。

dots的跨会话工作方式
01保持目标

保存进度与待办,定期检查连接信息

任务常驻
02云电脑执行

在独立浏览器与云电脑中处理网页、文件和工具

CPU活动
03分派与跟进

委派子智能体,跨应用继续完成任务

并行与反复执行

常驻指工作状态可持续与主动跟进;CPU采购取决于实际活动核时和高峰并发。

Meta Muse让个人智能体拥有持续工作的云电脑

从日常目标、浏览和填表,到购买前请用户批准,任务开始跨越多个应用和会话。

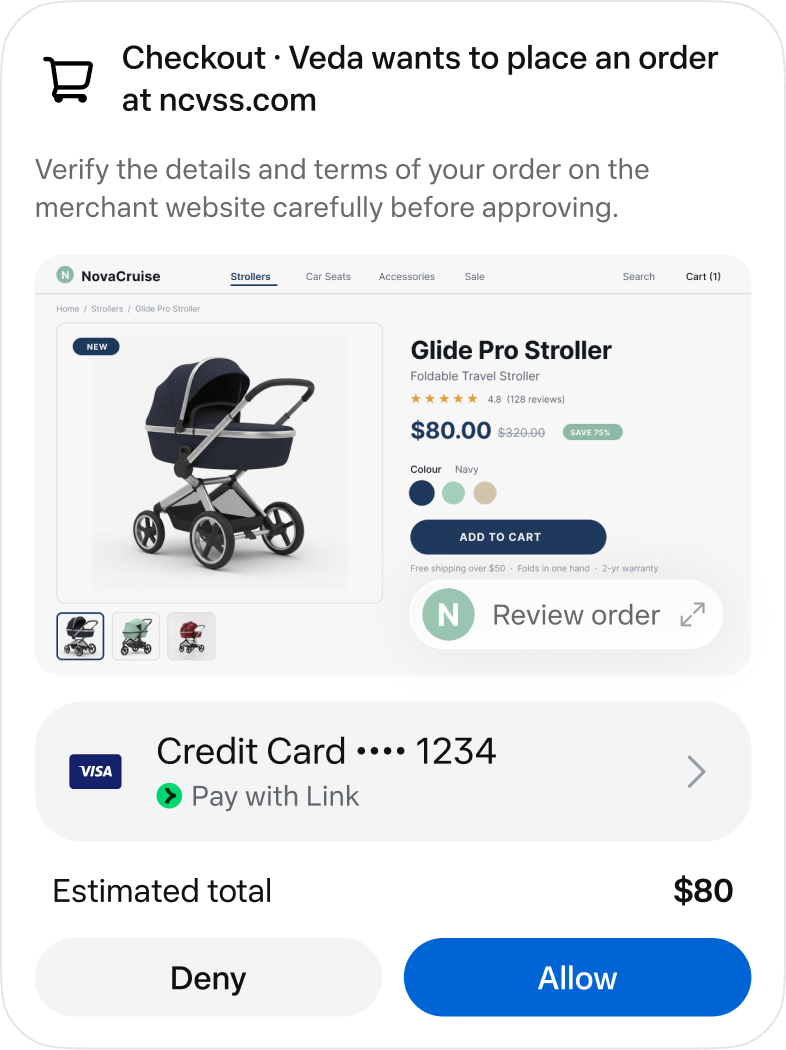
Meta于2026年9月在美国推出Muse,入口覆盖应用、网页和WhatsApp。用户可以委托它整理邮件、网页和日历信息,浏览网站、填写表格、运行代码或安排定时任务;离开界面后,后台工作仍可继续。购买和发送邮件等敏感操作需要用户确认。

Muse为每位用户提供隔离的Linux云电脑,保存浏览器、文件和任务状态,并支持并行子智能体。基准情景假设执行月活中35%当天运行任务、所有沙箱合计活动90分钟;Meta尚未披露这两项实际用量。

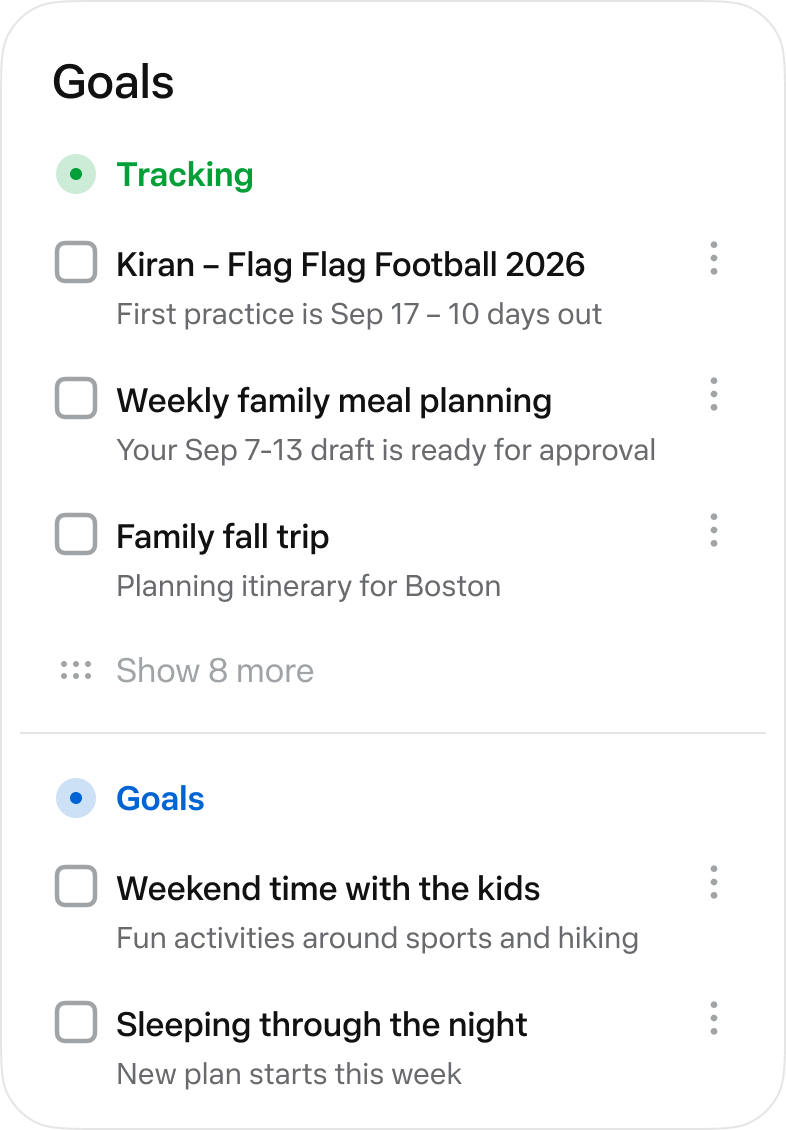
Meta Muse:从目标到执行,再到用户确认
Meta官方Muse Goals界面,展示长期目标与计划Goals · 持续推进目标
Meta官方Muse Checkout界面,展示购物付款前请用户确认Checkout · 操作前确认

Meta官方产品界面:左侧是持续推进的目标,右侧是付款前的用户确认。云电脑保存工作状态,让任务可以跨会话继续。

查看Meta发布与演示 ↗

Grok Bot和云沙箱把长期任务变成可共享的计算池

有状态的工作区可以持续存在,但等待模型或用户时不必持续占用物理CPU。

Grok Bot支持后台任务和多个Bot协作。一项匿名云服务商访谈描述了另一种部署:个人智能体运行在独立虚拟机中,通过接口调用分开的GPU推理服务;受访者给出的单实例示例为2个虚拟CPU和8GB内存。

用户离开后,任务状态可以保存,待运行的任务仍可在后台继续。需求测算进一步区分注册、付费、月度执行和当天实际运行的人数,并为高峰保留容量。

个人智能体执行环境
01任务进入

用户委托浏览、文件与定时任务

02保存状态

文件与浏览器可跨会话接续

03按需运行

运行代码或工具时使用CPU核时

04等待与复用

空闲沙箱暂停,物理核服务其他任务

访谈中的2个虚拟CPU、8GB内存是单个沙箱的资源配额,实际物理CPU占用随任务状态变化。

企业智能体增加的是任务次数与工具调用

编程、办公与业务流程可以在云端持续运行,单个员工也可能同时派发多项任务。

OpenAI的Agents API为长时任务提供云端执行环境。Meta与亚马逊云签署协议,计划从数千万颗Graviton核心起步部署多种AI相关负载;协议未披露Muse单独使用量或实际芯片颗数。这显示大型企业已经为云端CPU工作安排具体资源。

企业智能体会读取数据、运行测试、调用系统,再由人审查结果。生成查询和重做报表还会使用数据库CPU,其中一些工作替代原有人工查询。新增采购要看每天实际运行的任务、每项活动核时及既有服务器的余量。

一项企业任务的执行闭环
01分配任务

代码修改、文档整理或业务操作

02隔离执行

调用终端、浏览器、企业工具与测试

03人工审查

核对结果、合并或退回,再次执行

分母是每日活跃任务实例,不能和企业员工人数、IDC活跃智能体数量直接相加。

多智能体让可拆分任务并行运行

分支可以同时检索、写代码、做实验,最后还需汇总、去重与验证。

Anthropic曾让45个协同智能体各在独立虚拟机中执行安全研究;OpenAI在一项数学研究中组织约1万个并发智能体。两个案例展示了任务拆分和并行执行的能力,但都未披露物理CPU配置。

基准情景假设30%企业任务可拆分,平均3个分支,并计入协调计算。Google控制实验也发现,多智能体对可并行任务有利,但强顺序任务可能表现更差。

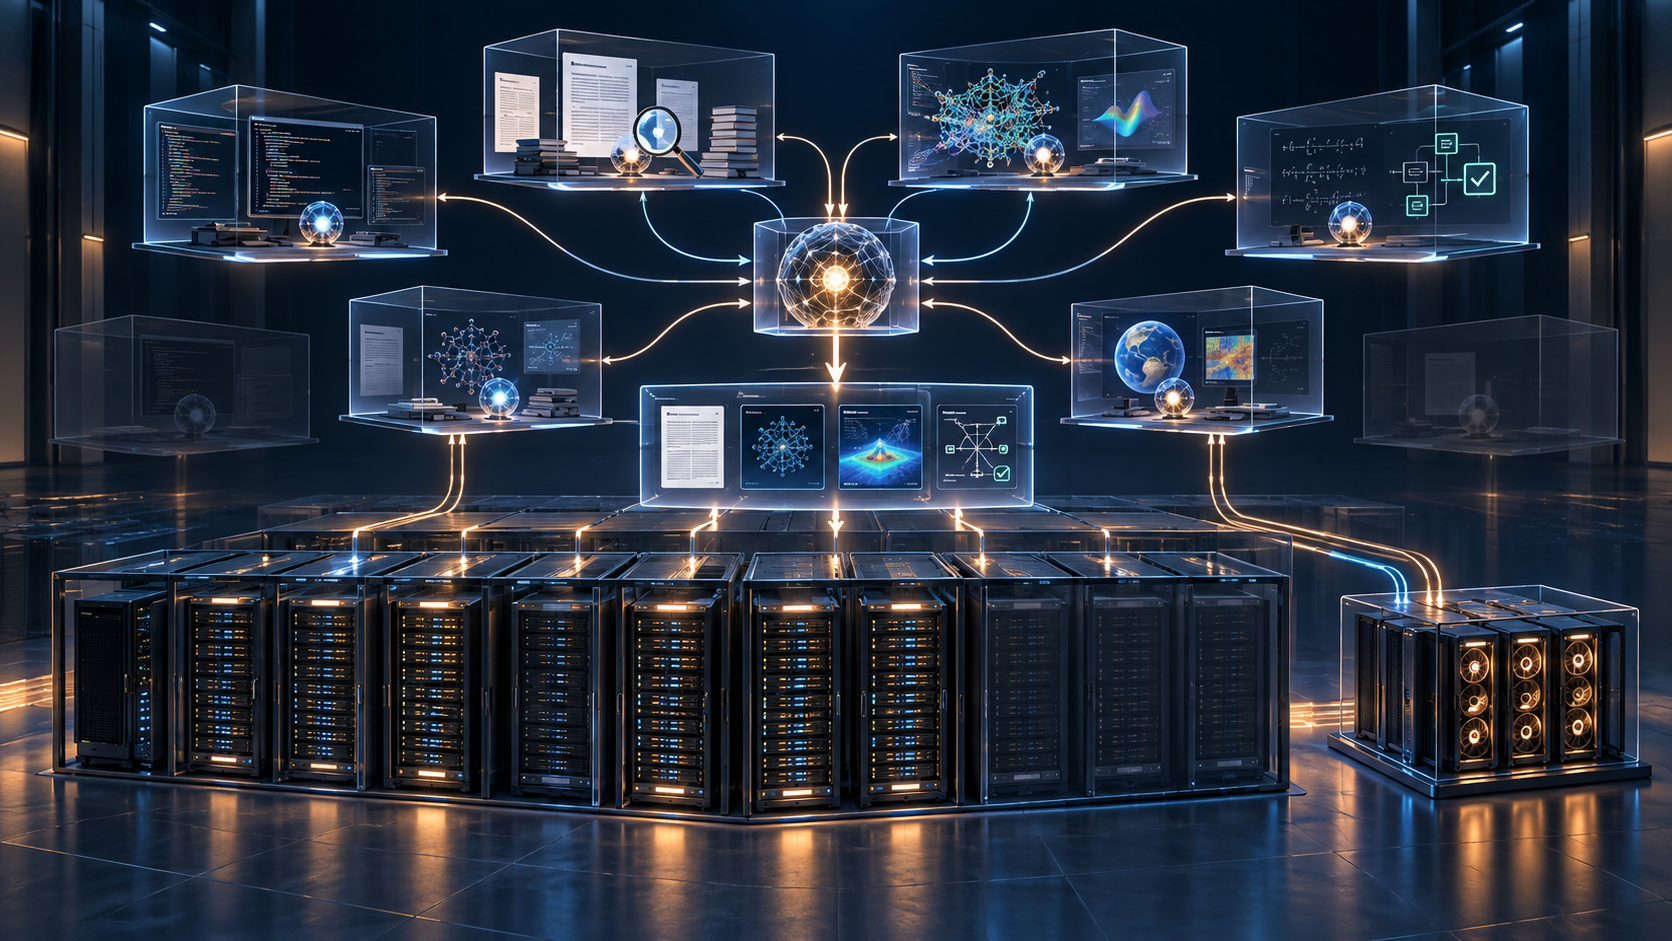
可拆分的科研任务,让多个沙箱并行执行 · 点击放大
示意插画:多个隔离的AI科研沙箱并行检索、写代码、做模拟和形式化验证,底部共享CPU机柜,部分沙箱暂停;右侧GPU服务提供模型推理

概念插画:并行沙箱共享CPU执行池,模型规划和判断交给右侧GPU服务;等待中的沙箱可暂停。

万级智能体科研显示极端并发可能出现

这是一项高强度示范:从寻找思路到运行代码、汇总结果和验证证明,持续近五天。

OpenAI在流体运动的纳维—斯托克斯难题研究中组织约1万个并发智能体,约88小时形成解析证明,随后又用Lean软件花17小时逐步检验。此前,约100个智能体合作50小时解决了一个相关的欧拉方程子题。

这是AI科研可能产生高强度执行任务的案例。克雷数学研究所认为成果看来解决了问题,正式审查仍在进行;研究团队没有公开这次任务使用了多少CPU。

OpenAI数学研究:任务规模与工作类型
01分组搜索

约1万个并发智能体探索不同命题

约88小时
02工具执行

运行代码、检索资料、交叉汇总

约270万条消息
03形式验证

Lean证明检验软件逐步核对,另耗约17小时

逐步核查

解题全程约生成1300亿个词元(token,模型输出的计量单位);这是模型活动量,研究团队未披露CPU核心或芯片数。

AI科研还有大量较小、可重复的工作流

数学证明是极端峰值,常态需求更可能来自代码分析、专业软件与反复验证。

更常见的科研工作规模较小。OpenAI称每周约130万人用ChatGPT做高级科学与数学工作,产生约840万条消息,但未披露其中多少调用了计算工具。Anthropic的一项数学研究让约60个子智能体在一天半内运行2400条命令和数百个Python脚本;另一项工作把已知的费马大定理写成可由软件逐步检验的证明。

Google的AI co-scientist让不同智能体提出、反思和筛选假设;Empirical Research Agent能自动评测数千个代码变体。专家访谈提示,当前更多科研用途仍是阅读文献、写代码和局部调用专业软件,跨软件完成“计算—解析—验证”的闭环尚未普及。工作也可能由实验室现有集群或本机承接,2030年新增CPU采购因此仍有较大不确定性。

从研究假设到可检验结果
01提出候选

阅读文献、生成假设与研究计划

02运行实验

统计分析、仿真、专业软件或实验工具

CPU/GPU混合
03复现验证

复跑脚本、比对结果、整理证据

可重复核时

已有实验室集群、本机与云端按需资源都可能承接,不能把全部工作记作新增云CPU。

AI芯片研发本身也在形成工具执行负载

模型辅助设计时,电子设计自动化软件要反复综合、验证和筛选候选方案。

阿里巴巴公布的芯片设计实验持续60余小时,模型调用电子设计自动化工具超过1万次,并报告总线模块面积改进。这是“模型生成方案、CPU工具运行、再把结果反馈给模型”的具体例子。

这类负载可能落在企业研发服务器、云平台或既有设计集群;预测将未被个人、企业和AI科研覆盖的采购归入“其他AI负载”,避免重复计算。

AI芯片研发的闭环
01提出设计

模型修改硬件描述与参数

02运行工具

电子设计自动化工具执行综合和验证

CPU密集步骤
03反馈优化

比较面积、速度和正确性,再迭代

阿里披露的是单项芯片设计实验,不代表整个半导体行业采用率。

后训练把沙箱变成反复调用的训练设施

强化学习让模型在可验证环境中尝试、执行、得分和改进。

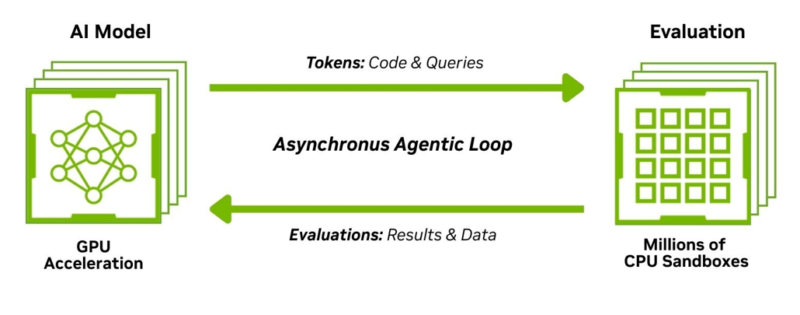
编程、浏览器或规则环境可以自动给模型反馈。GPU负责模型生成与训练,CPU负责创建环境、运行代码或工具、评分与清理。训练规模扩大时,环境并发和可靠性成为独立的系统工程。

DeepSeek公开的生产系统中,单个任务最多可请求3.2万个沙箱,显示执行环境已能按训练任务大规模调度。实际CPU采购仍取决于每轮运行的核时和资源复用效率。

后训练的模型—环境—反馈循环研究资料图表 · 点击查看原图
强化学习与沙箱交互示意图

训练反复启动环境、执行动作并评分,调用次数与运行时间共同决定CPU工作量。

执行沙箱的扩容空间随用户和任务强度持续打开

GPU机头随加速器配置增长,后训练依赖实验规模;个人执行池还会随使用人数、频次和单次任务深度改变。

三条需求的驱动不同。GPU机头主要跟随加速器系统出货及每套系统的CPU配置;后训练环境跟随活跃模型项目、训练与评测运行;个人执行沙箱则同时受实际执行用户、当天任务比例、活动核时和高峰并发影响。增加用户不一定等比例增加芯片,但更长的后台任务和多个子智能体会放大单人用量。

所选情景的2030年个人执行月活为25.5亿,沿用本站个人智能体用户路径;在此之上另设35%当日执行和90分钟活动时间。右图只解释三类工作随部署扩大的相对弹性,不表示当前情景的采购量排序;年度CPU颗数由后文七类模型计算。

CPU 需求弹性三类工作负载

执行沙箱打开最大的部署弹性

共享集群的增量逐步放缓,用户执行需求随部署持续扩张

GPU 主机和强化学习环境的需求增长由陡转缓;执行沙箱需求随智能体部署规模持续扩大。

GPU 集群主机数据准备、调度与传输
共享效率影响扩容斜率

强化学习环境运行环境、返回奖励
复用与验证效率影响需求

智能体执行沙箱更多用户 × 更多任务 × 更长执行核时,形成独立 CPU 扩容来源

三类 CPU 需求随部署扩张的定性示意。曲线交叉没有实测年份含义,也不代表市场份额;每颗 CPU 有效算力提升,会降低同等任务所需的芯片数量。

传统工作仍是CPU需求的底座

数据库、网站、企业软件及既有云工作不会因AI扩张而自动消失。

通用服务器更新与企业软件仍是CPU需求的基盘。AI增加GPU机头和机头之外的执行工作,三者共同使用晶圆、封装基板与内存。

所选情景中2030年传统业务约2786万颗/年,GPU机头约1509万颗/年,机头之外的AI工作约725万颗/年。

2025基点与2030年服务器CPU需求结构

同一情景下的年度采购;2025年是研究起点,2030年是预测

2025研究起点2030需求情景
悬浮或点选查看;键盘可逐期查阅
2025基点与2030年服务器CPU需求结构;左轴:百万颗CPU / 年
期间2025研究起点2030需求情景
传统业务20.6527.86
GPU机头3.5715.08
机头之外的AI工作0.80277.25

2025年以服务器CPU芯片市场估计量为总量基点,再拆分传统与AI工作;2030年各分项均为情景预测。机头之外的AI工作包括个人、企业、AI科研、后训练与未单列负载,可使用独立机柜、通用服务器或科研集群。

查看图表数据
2025基点与2030年服务器CPU需求结构;柱/左轴:百万颗CPU / 年
时期 / 项目2025研究起点2030需求情景
传统业务20.6527.86
GPU机头3.5715.08
机头之外的AI工作0.80277.25
04
SYSTEM ARCHITECTURE

AI把CPU部署到机头、通用服务器与独立机柜

GPU机头跟随加速器系统配置,科研与训练可使用通用CPU服务器,个人和企业智能体还会建设独立执行池;三类部署的采购驱动不同。

AI把CPU放进GPU托盘、科研服务器和独立执行机柜

三种位置对应不同的采购量尺:加速器配置、科研与训练核时、云端工具任务并发。

GPU机头:CPU随计算托盘交付,负责操作系统、模型与缓存装载、网络和存储输入输出,并把请求送入加速器。GPU越多、服务越频繁,机头的内存带宽和CPU核数越不能只按旧式训练服务器配置;采购颗数仍首先取决于各代GPU系统的实际CPU配比。

科研与后训练服务器:科研智能体运行代码、形式化证明、仿真和数据分析;后训练反复创建环境、执行动作、验证结果、给出分数。这类任务可能占用整组核心数小时,也可能短时间并行启动大量沙箱。因此应按实际执行次数、每次活动核时、高峰目标利用率和可调度核心数算容量。

独立执行机柜:个人和企业智能体可以在GPU柜外运行浏览器、文件和专业工具,再通过网络调用模型。CPU机柜集中承接多用户任务,闲置环境可暂停;高峰会话、内存驻留和恢复延迟仍决定要预留多少机器。高核心数芯片提高了内存、载板、封装和网络的要求。

CPU部署的三种形态:机头、通用服务器与独立机柜
示意插画:GPU机头、科研训练CPU节点与独立CPU机柜

上图为场景插画;下方分别给出可核对的机头配置、通用执行节点和独立机柜实例。

GPUCPUGPUGPUCPUGPU
① GPU机头

CPU就在计算托盘里,连接GPU并管理数据、网络与存储。英伟达GB300每托盘配2颗CPU、4颗GPU。

查看官方托盘结构 ↗
实验 A实验 B训练环境CPU执行节点
② 通用CPU服务器

科研与后训练任务可在通用服务器或现有集群运行代码、仿真、测试和强化学习环境。

英伟达Vera独立CPU机柜
③ 高密度独立CPU机柜

CPU集中承接云端工具与沙箱执行,模型推理由另一组加速器机柜承担。Vera设计最多256颗CPU/柜。

智能体提高CPU相对需求,主要增量不必都塞进GPU机柜

全系统CPU/GPU比例上升,包含机头配置变化和柜外独立执行池扩建。

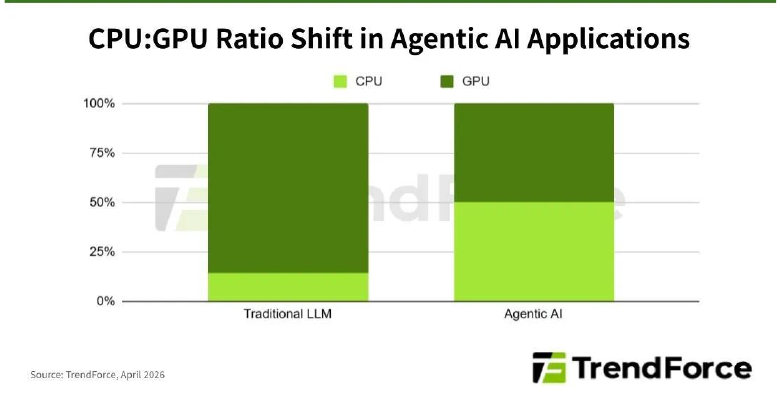
TrendForce预计,部分智能体部署的CPU与GPU配置可能从约1:4—1:8转向1:1—1:2。AMD强调,这种变化主要通过在GPU柜旁增加独立CPU机柜实现,而非把所有CPU都装进GPU服务器。因此本报告把机头和柜外执行分别计量。

下方分别展示GPU柜内的机头CPU和柜外独立CPU机柜。两种位置服务的工作不同,本报告分别测算。

TrendForce对智能体场景CPU/GPU配比的概念预测研究资料图表 · 点击查看原图
TrendForce关于传统大模型与智能体应用CPU和GPU相对配比变化的概念图

部分部署的全系统CPU:GPU比例可能由1:4—1:8走向1:1—1:2;图中包含GPU柜外的CPU执行资源。

机头CPU是GPU系统的一部分

它管理操作系统、数据、网络和存储,数量随加速器系统设计变化。

传统八卡服务器常以两颗CPU支撑八颗加速器;英伟达NVL72采用36颗Grace CPU配72颗GPU。不同系统的内存、互连和任务调度方式不同,平均配比应按出货组合变化。

本站总量模型给出2025—2030年加速器年度出货路径,机头CPU按每年混合系统的平均配比计算。基准情景中该比率从2025年每颗加速器0.30颗CPU变为2030年0.35颗,得到约1509万颗年度机头需求。NVL72的0.50是单一系统实例,不等于全行业均值。

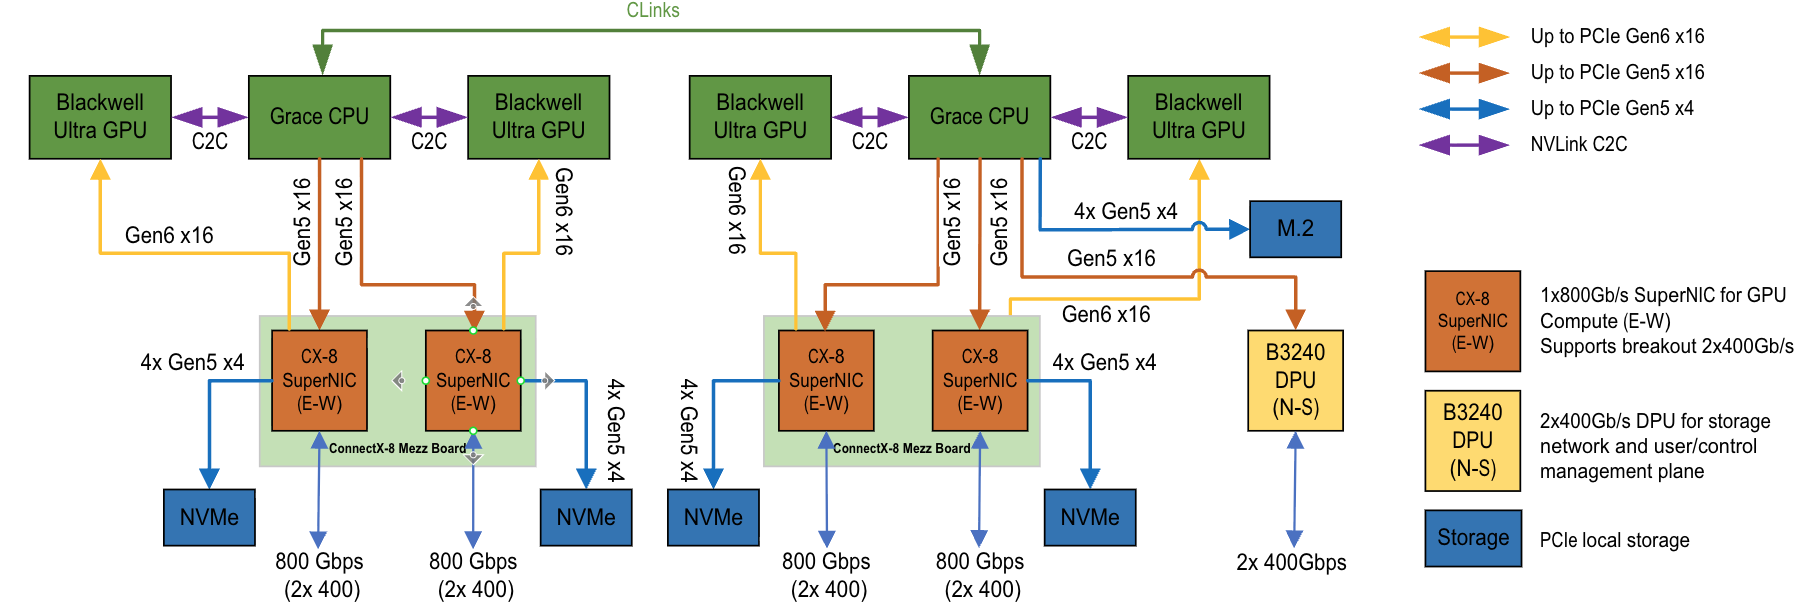
计算托盘内,机头CPU直接与GPU相连
英伟达GB300计算托盘逻辑图,上方2颗Grace CPU分别连接4颗Blackwell Ultra GPU,下方是网络与存储
GB300 示例1托盘:2颗Grace CPU + 4颗GPU1机柜:36颗CPU + 72颗GPU

GPU机头CPU配比随系统出货结构变化

英伟达NVL72每两颗GPU配一颗CPU;全球混合系统的平均配比由不同机型权重决定。

常见八卡系统的两颗机头CPU对应0.25颗CPU/加速器;英伟达GB300和Vera Rubin机柜为36颗CPU配72颗GPU,即0.50。新系统部署比例上升可能推高行业机头平均配比,但自研加速器与不同服务器形态会使全行业平均低于单一高密度机柜。

模型在2025年0.30的混合起点上,按所选情景调整到2030年0.35;未调参的审慎、基准和高需求预设分别为0.30、0.35和0.45。整体智能体CPU/GPU比率如果接近1:1,还需要计入另一侧的独立执行池,不能把全部增量塞入机头。

2025—2030年GPU机头CPU采购与平均配比

柱为年度机头CPU;折线为每100颗加速器对应的机头CPU

机头CPU年度采购平均机头配比
悬浮或点选查看;键盘可逐期查阅
2025—2030年GPU机头CPU采购与平均配比;左轴:百万颗CPU / 年;右轴:颗CPU / 百颗加速器
期间机头CPU年度采购平均机头配比
2025基准3.5730
2026E5.8931
2027E8.7132
2028E10.2633
2029E12.6134
2030E15.0835

2025年0.30为研究拟合起点;2030年基准情景为0.35。右轴仅计GPU系统内部的机头CPU;独立CPU机柜在执行池单列。

查看图表数据
2025—2030年GPU机头CPU采购与平均配比;柱/左轴:百万颗CPU / 年;折线/右轴:颗CPU / 百颗加速器
时期 / 项目机头CPU年度采购平均机头配比
2025基准3.5730
2026E5.8931
2027E8.7132
2028E10.2633
2029E12.6134
2030E15.0835

独立CPU机柜服务GPU柜外的执行、训练与数据处理

它可以集中承接多个业务,而无需附着在每个GPU托盘里。

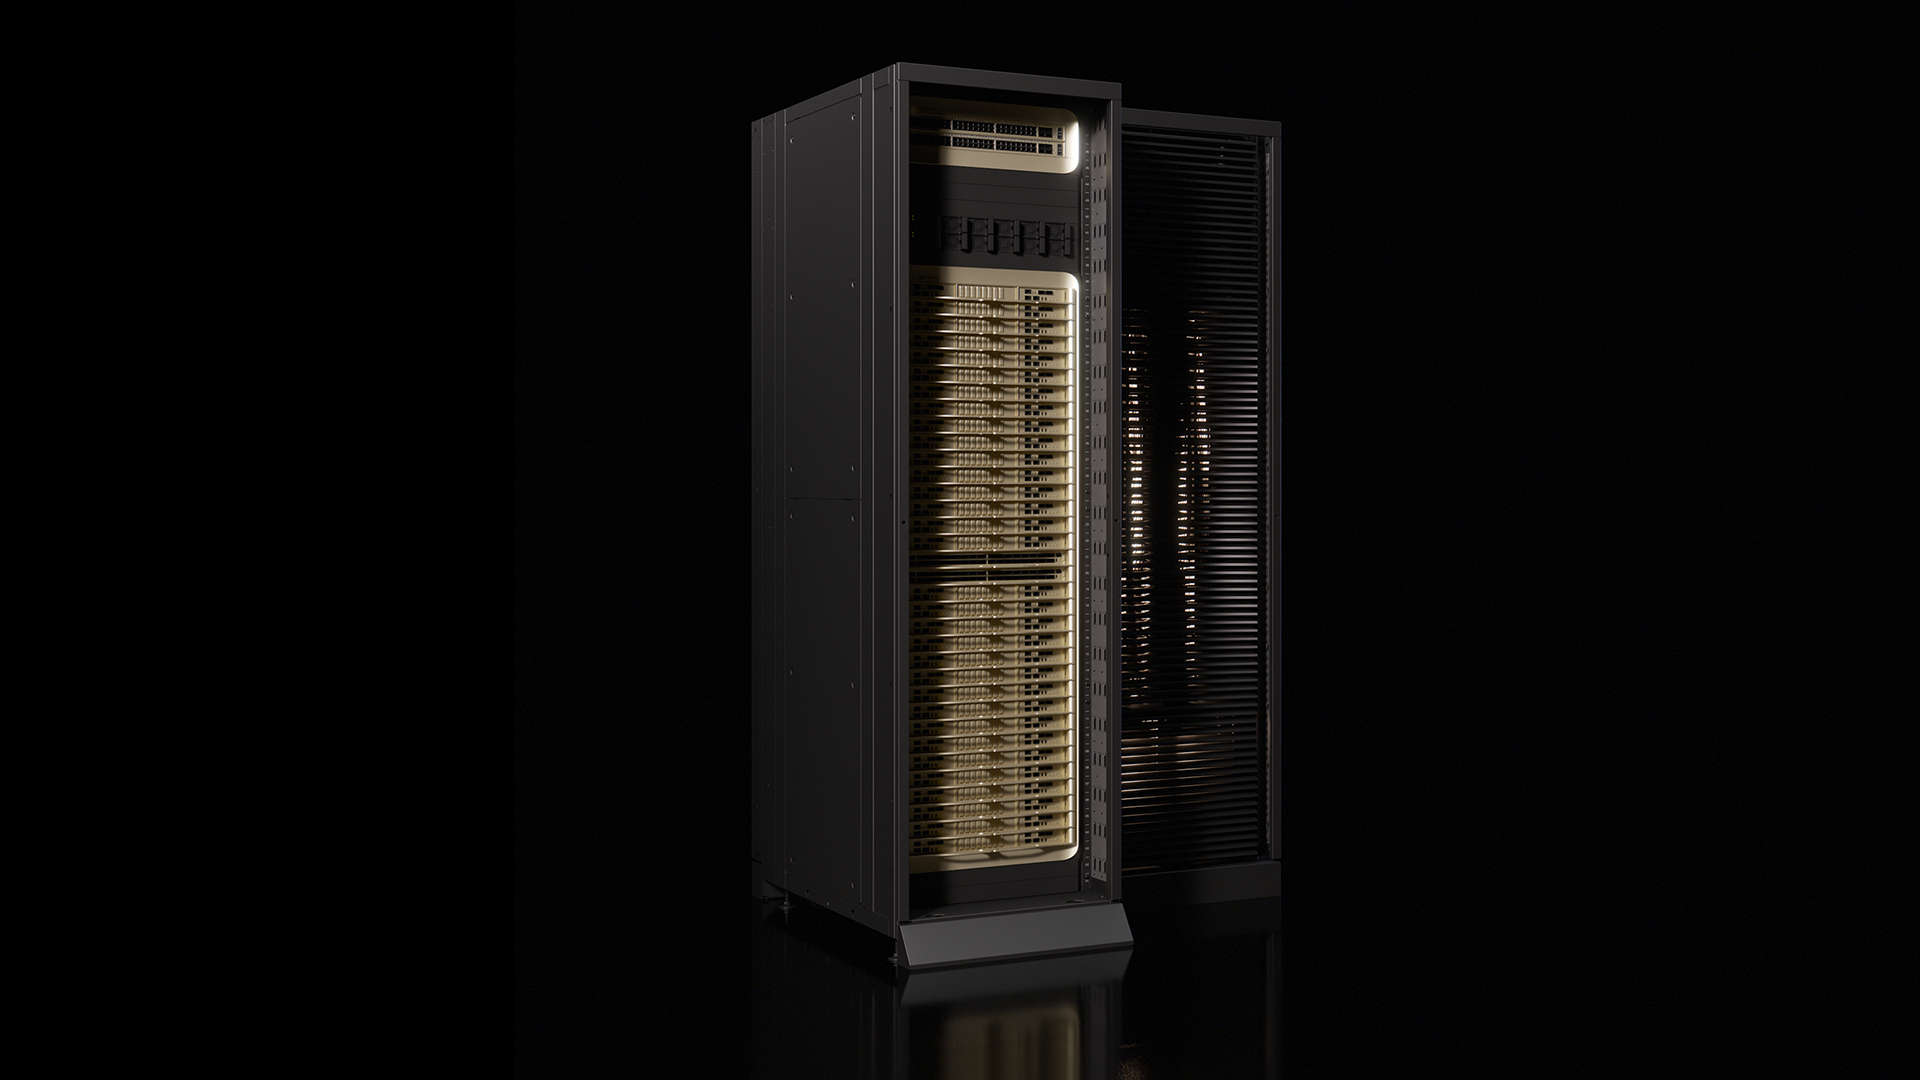
英伟达的Vera独立机柜参考设计最多放256颗CPU,公司称可维持超过22,500个并发智能体沙箱。图片只展示CPU机柜;模型推理仍需另一组GPU机柜。单看GPU柜内的CPU配比,会漏掉这类柜外执行资源。

个人、企业、AI科研和后训练四类按活动核时推算的执行需求,2030年约496万颗CPU/年。若当年采购全用于建设256颗/柜的Vera式独立机柜,芯片数相当于约19,381柜/年的新建规模;实际也可用通用服务器或科研集群承接。

约229万颗/年的“其他AI负载”覆盖数据准备等工作,目前缺少独立的行业统计;它不纳入上述机柜等值。实际部署可能分散在通用服务器和科研集群。

Vera独立CPU机柜集中承接工具执行
英伟达Vera独立CPU机柜产品图,仅展示CPU机柜
Vera 设计示例图示为独立CPU柜:最多256颗CPU模型推理另由GPU柜承担,GPU柜未在图中展示

芯片核心数提升会缓和颗数,却增加系统配套要求

每颗CPU能服务更多任务,前提是内存、封装和网络跟得上。

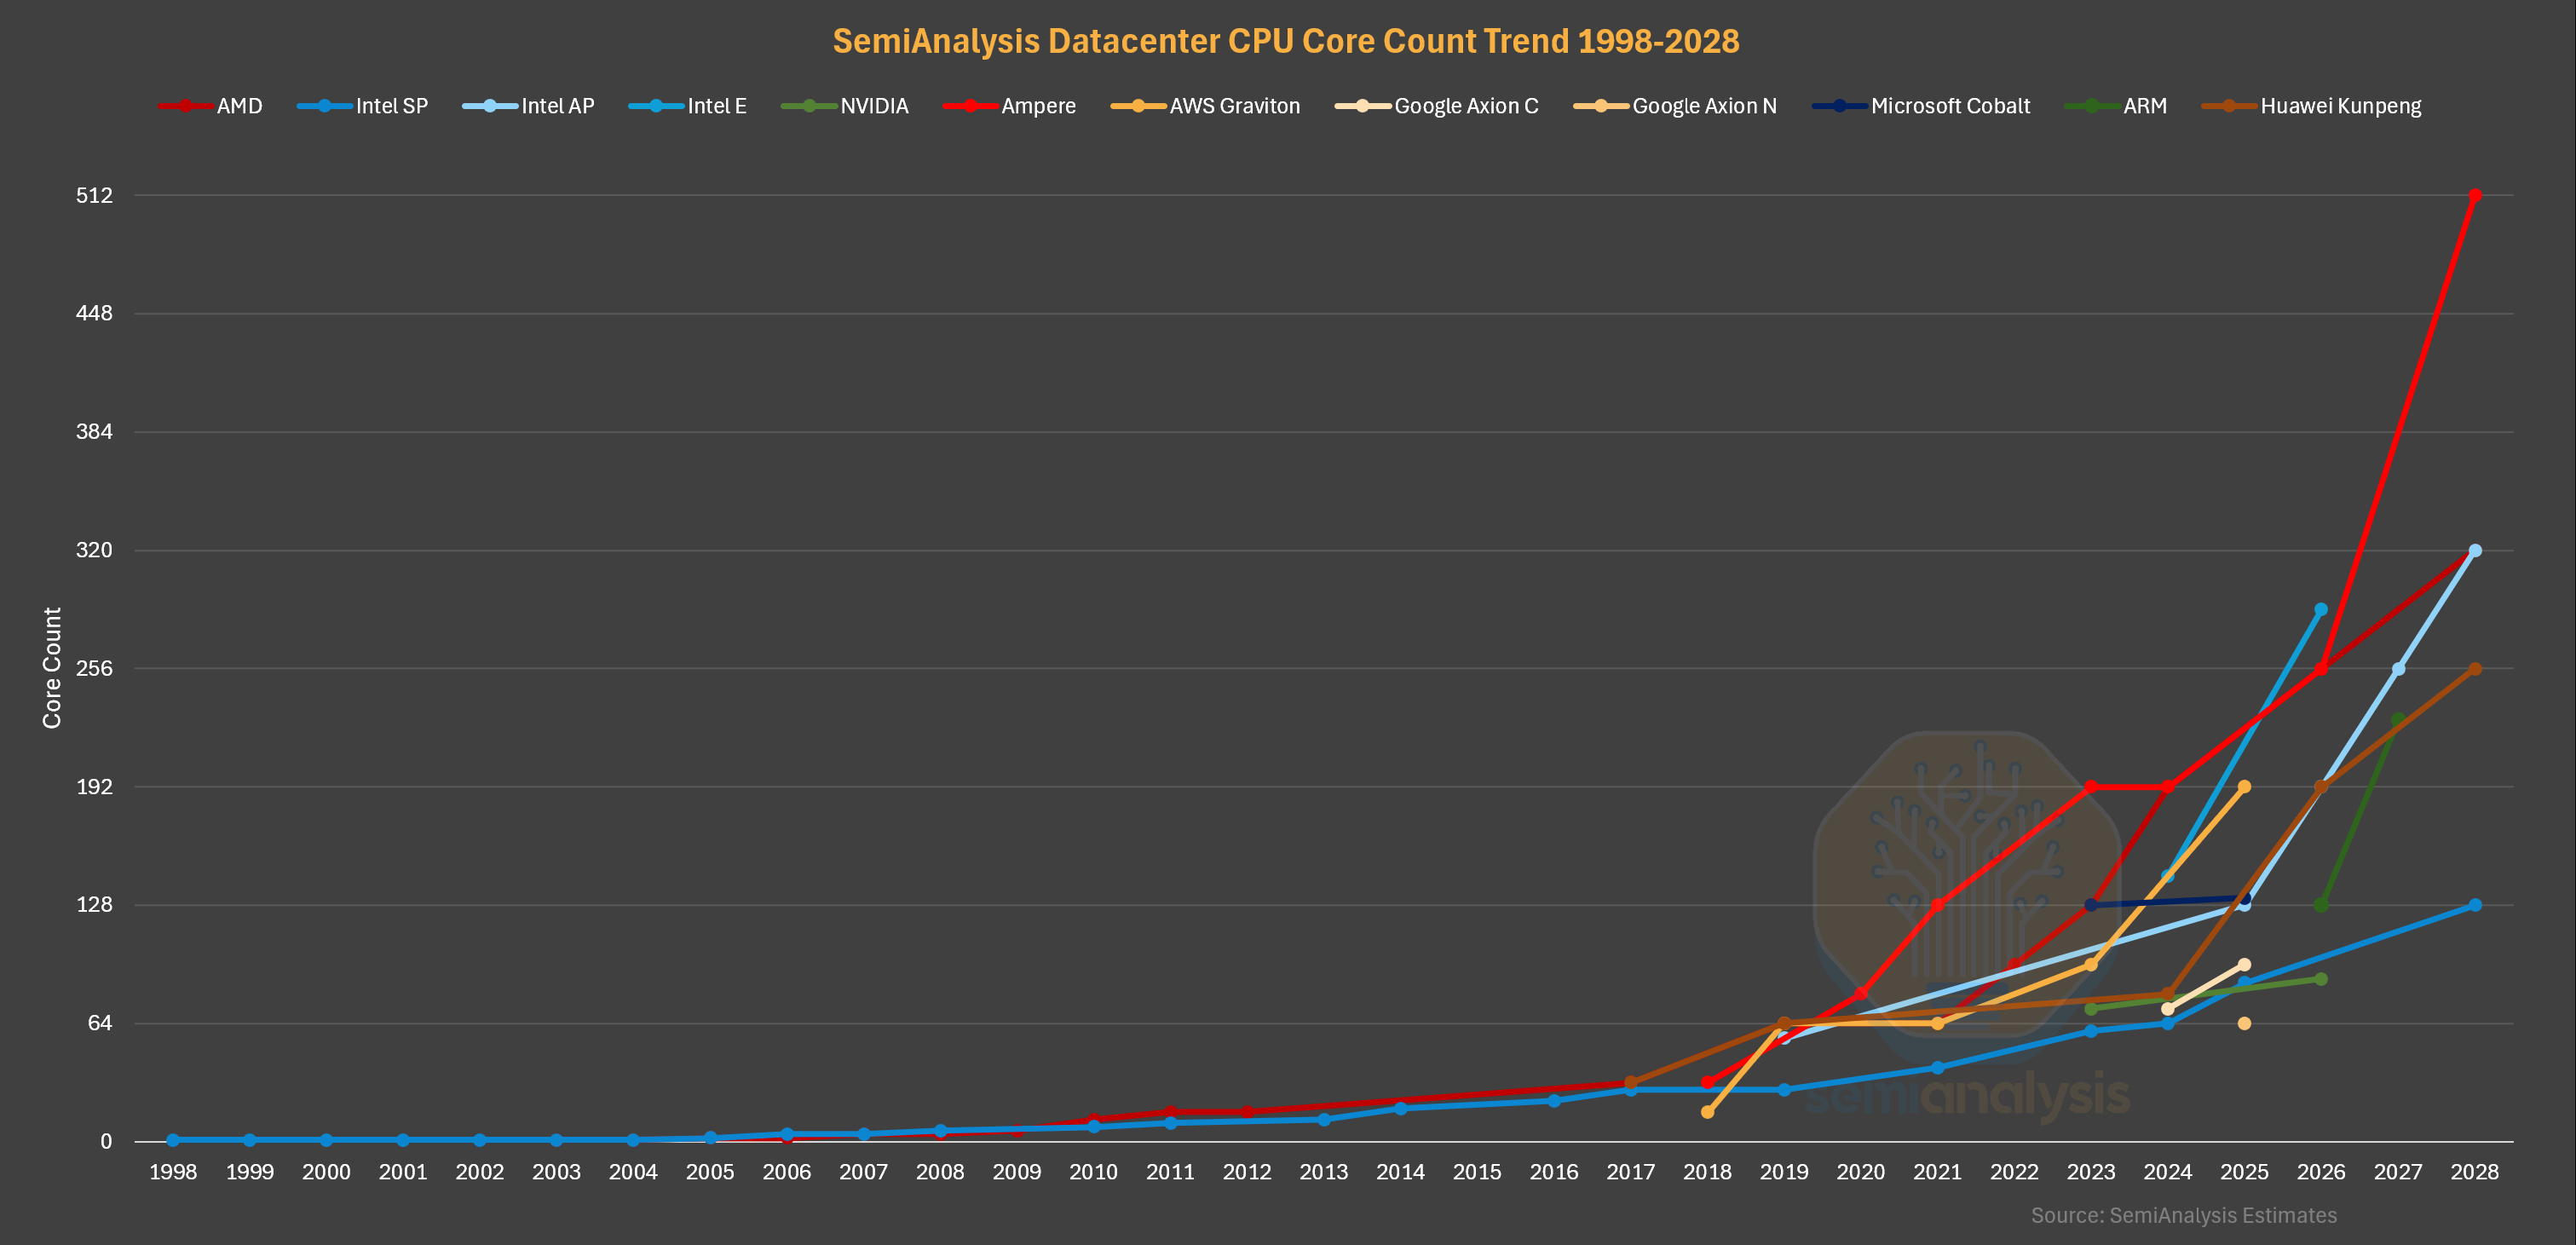
AMD、第六代英特尔至强以及Arm、高通等路线继续提高单芯片或单机柜核心密度。单纯按任务数线性乘CPU颗数会高估需求;但更多核心同时需要更高内存带宽、载板布线、散热和网络能力。

不同指令架构各有软件迁移成本。x86在既有服务器生态广泛,Arm便于云厂商定制,RISC-V提供开放定制空间;产品实际能耗与性能需按负载测试。

数据中心CPU核心数与产品路线演进研究资料图表 · 点击查看原图
服务器CPU核心数与产品路线图

图中后续型号属于产品规划或研究预测;不同架构的核心能力还需按负载比较。

05
RESOURCE EFFICIENCY

池化节省空闲算力,高峰并发仍决定CPU容量

云端快照能释放暂停任务的资源;个人智能体同时运行的会话,以及AI科研长时间占用的核心,限制了池化收益。

沙箱暂停后,物理CPU可以服务下一项任务

快照保存工作状态,资源池把等待时段的计算能力交给正在运行的任务。

沙箱是隔离运行代码与工具的环境。暂停时保存工作状态并释放运行资源;恢复时继续先前任务。平台仍要为高峰运行、恢复延迟以及内存和存储预留容量。

DeepSeek一个规模单元约160台CPU节点、约3万个物理核心,峰值存活沙箱约38万个;每核心对应约12.7个存活沙箱,不代表它们同时执行。论文中约九成容器与微型虚拟机的平均CPU使用率不高于申请额的5%。

快照与CPU池化的时间复用
01沙箱A运行

读取文件或执行代码,占用物理核

02A暂停并快照

保存必要状态,释放运行资源

03沙箱B接管

同一物理核服务另一个活动任务

04A恢复

读取状态继续任务,承担恢复延迟

虚拟CPU预留、存活沙箱数、同时执行核数是三个不同量。

活动核时和高峰决定共享CPU池的规模

先量出一天有多少任务真正运行,再加上高峰余量和芯片效率,才能估算采购。

容量测算依次使用当天运行任务数、每项活动分钟、平均物理核数,以及峰均比和高峰目标利用率。所需装机的年度增量,加上到期设备更新,才转成年度采购。

专业工具接口可能缩短逐屏操作时间,多智能体协作则可能增加并行活动。两者都会改变单位任务的CPU用量。

共享CPU池如何承接活动任务
01活动任务任务/日

当天真正运行工具的个人与企业任务、科研及训练环境

02有效核时核心小时/日

每任务活动分钟 × 物理核;并行分支另计

03规划容量CPU → 机柜

再考虑峰值、高峰目标利用率、每颗有效核心和机柜密度

芯片存量再结合新增装机与更新周期转为年度采购;完整公式见文末可展开测算。

为什么活跃智能体人数不能直接换成CPU颗数

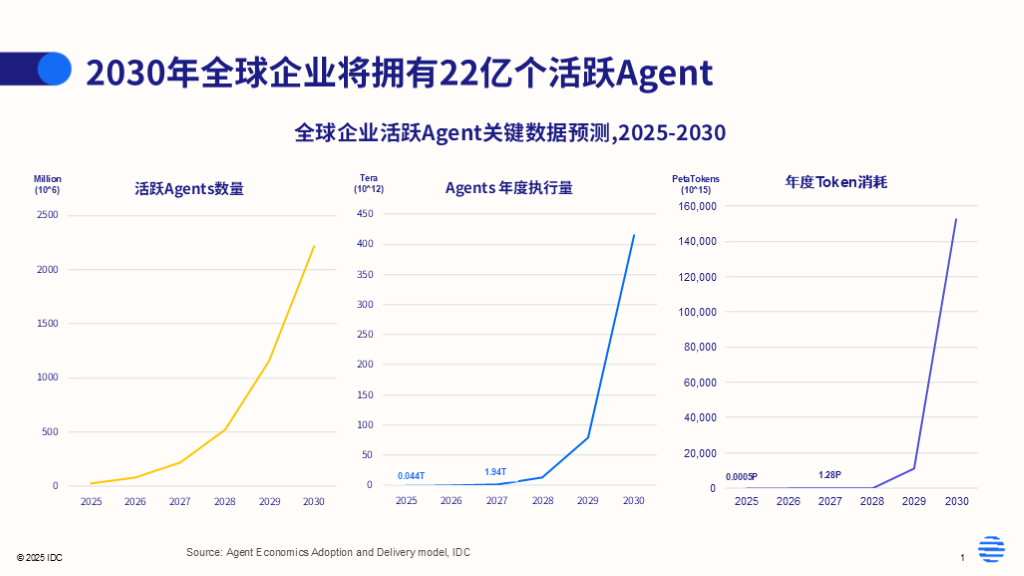
IDC对2030年约22.16亿活跃智能体的预测,没有披露其中每天执行任务的比例、每项运行多久或平台池化效率。假定每个智能体全天独占4核、每颗CPU有200核,会得到约4400万颗装机的静态上界;这一上界不是IDC的CPU预测,更不是年度采购。

IDC活跃智能体人数预测研究资料图表 · 点击查看原图
IDC对2025至2030年全球活跃智能体人数的预测曲线

机构预测的人数口径不能直接换算为物理CPU装机或年度出货。

06
2025—2030 DEMAND

基准情景下,2030年服务器CPU年度需求约5,020万颗

七类需求分别从服务器、加速器出货和实际执行任务出发,统一换算为当年需要采购的服务器CPU。

2025年服务器CPU有效交付基点设2,500万颗,其中主要x86服务器型号略低于2,000万颗,其余约500万颗为其他型号和架构的研究估计。本站总量研究给出AI加速器从2025年1,190万颗到2030年4,310万颗的出货情景;所选情景另设2030年企业每日约3.5亿项任务、AI科研每日1,000万项实际执行任务和后训练每日约8.0亿次环境运行。后三项是待验证的需求假设。

七类需求怎样变成年度CPU采购

前两类跟随服务器与加速器配置;四类执行工作先算装机容量,再加当年新增与到期更新;最后一类只记录未覆盖的AI任务。

设备与更新

传统服务器与基础云

2025年芯片基点中划出的非AI净需求 × 逐年净增长

2025年约2,065万颗;2026—2030年净增长依次为10%、8%、5%、4%、4%

2030年年度采购约2,786万颗
设备与更新

GPU机头CPU

AI加速器年度出货 × 当年机头CPU/加速器配比

加速器出货从1,190万至4,310万颗;平均机头配比由0.30升至0.35,独立CPU柜另计

2030年年度采购约1,509万颗
云端执行池

个人智能体

执行月活 × 当日运行比例 × 活动核时 → 高峰装机 → 新增与更新

2030年年均执行月活25.5亿、当天运行35%、每日合计90活动分钟×1核;与高峰25会话/CPU的容量下限取较大值

2030年年度采购约212万颗
云端执行池

企业智能体

每日实际任务 × 基础核时 × 分支与协调系数 → 装机 → 采购

2030年每日3.5亿项、每项240分钟×2核;可拆分任务与协调开销合计乘1.37

2030年年度采购约141万颗
长时间高负载

AI科研

每周实际运行工具的人数 × 每人每周独立作业 ÷ 7 → 每日核时 → 采购

2030年共同基线:每周600万人、每人约11.7项;基准情景每日合计1,000万项,每项加权180分钟×32核

2030年年度采购约119万颗
高并发实验

大模型后训练与评测

等效活跃项目 × 每项目环境运行次数 → 加权核时 → 采购

2025年250个项目等效×每日30万次;2030年共同基线1000个×每日80万次,情景调整后每日80,000万次;单轮25分钟×2核

2030年年度采购约25万颗
去重代理

其他AI负载

未被上述六类覆盖的2025年CPU采购基数 × 情景增速

以2025年75万颗为起点,逐年向基准情景的目标增速25%过渡;涵盖检索、数据准备、AI芯片研发与物理AI云端模拟

2030年年度采购约229万颗

2025年为市场芯片量拟合起点,2026—2030年均为研究情景。四类执行池采用各自的峰均比与高峰目标利用率;完整参数和更新批次见下方可展开口径。

核心密度提高,芯片颗数不随任务核时等比例增加

传统、机头与智能体执行池按采购组合中的平均物理核心数估算;科研任务常受内存与整节点预约限制,另按每颗可调度核心数估算。这些是年度产品组合假设,不是单一芯片规格。

2025—2030年服务器CPU核心密度研究假设;单位:核心/颗。前三类为物理核心组合,AI科研为可调度核心
年份传统销售组合
物理核心
GPU机头组合
物理核心
智能体与后训练池
物理核心
AI科研
可调度核心
2025基准647212864
2026E728012864
2027E808814480
2028E969616096
2029E112112176112
2030E128128192128

服务器CPU年度采购:传统业务与六类AI相关需求

2025年为拟合基点,2026—2030年为可切换的研究情景

传统负载GPU机头CPU个人智能体企业智能体AI科研后训练强化学习其他AI负载
悬浮或点选查看;键盘可逐期查阅
服务器CPU年度采购:传统业务与六类AI相关需求;左轴:百万颗服务器CPU / 年
期间传统负载GPU机头CPU个人智能体企业智能体AI科研后训练强化学习其他AI负载
2025基准20.653.570.00250.01960.01030.02030.75
2026E22.725.890.06830.25510.0720.07190.9375
2027E24.538.710.42290.40330.10490.08031.17
2028E25.7610.260.90530.82890.22410.1071.46
2029E26.7912.611.571.020.53890.14331.83
2030E27.8615.082.121.411.190.24812.29

年度采购包含新增与更新,七类需求互斥;2025年以服务器CPU芯片市场估计和任务活动假设拟合,并非全球CPU官方统计。不含个人电脑、手机和机器人本体CPU。

查看图表数据
服务器CPU年度采购:传统业务与六类AI相关需求;柱/左轴:百万颗服务器CPU / 年
时期 / 项目传统负载GPU机头CPU个人智能体企业智能体AI科研后训练强化学习其他AI负载
2025基准20.653.570.00250.01960.01030.02030.75
2026E22.725.890.06830.25510.0720.07190.9375
2027E24.538.710.42290.40330.10490.08031.17
2028E25.7610.260.90530.82890.22410.1071.46
2029E26.7912.611.571.020.53890.14331.83
2030E27.8615.082.121.411.190.24812.29
2030年基准情景

年度需求约5,020万颗,其中传统负载2,786万颗、GPU机头1,509万颗、机头之外的AI工作725万颗。

查看年度分项与完整换算口径
七类年度服务器CPU采购需求;单位:百万颗/年
年份传统负载GPU机头个人智能体企业智能体AI科研后训练其他AI需求合计
2025基准20.653.570.000.020.010.020.7525.02
2026E22.715.890.070.260.070.070.9430.01
2027E24.538.710.420.400.100.081.1735.42
2028E25.7610.260.910.830.220.111.4639.55
2029E26.7912.611.571.020.540.141.8344.51
2030E27.8615.082.121.411.190.252.2950.20

个人智能体:实际执行月活用户池 × 当日执行占比 × 每日所有沙箱合计的CPU活动分钟 × 活动期物理核数 × 峰均比 ÷(1,440分钟 × 每颗有效物理核数 × 高峰目标利用率),再与高峰同时运行会话所需的最低CPU容量取较大者。企业智能体以每日活跃任务实例为基础,仅对可拆分任务增加分支执行和协调核时。四类执行池的年度采购=新增装机+达到四年更新周期的设备;2025年已建容量按四个等额年龄批次估算。

AI科研每日实际软件作业=每周实际运行工具的科研用户 × 每人每周独立作业数 ÷ 7。2030年共同基线为600万周用户 × 11.7次/周,约1,000万次/日;经所选情景强度调整后为1,000万次/日。再按每次180活动分钟、32物理核及科研池的峰均比、高峰目标利用率、可调度核心计算装机。全球研究人员和当前高级科研产品用户只作采用率参照,不能直接当已运行作业。

后训练与评测每日环境运行=等效活跃项目数 × 每项目每日运行次数。2025年设250个项目等效、每项目每日30万次;2030年共同基线设1000个、每项目每日80万次,情景调整后为80,000万次/日。每次平均25活动分钟×2核,是包含较重代码、浏览器、评测和评分作业的加权假设;DeepSeek轻量沙箱的单位核时更低,不直接套入。其余AI负载以2025年75万颗CPU为去重基点,涵盖未在四类执行池中计入的检索、数据准备、AI芯片研发与物理AI云端模拟。

2025年服务器CPU有效交付基点设2,500万颗:Mercury Research转述的AMD EPYC与英特尔至强可扩展处理器合计略低于2,000万颗,再加约500万颗其他架构和型号的研究估计。传统及未单列基础业务从总量中划出约2,065万颗,已扣除单列AI任务;基准情景2026—2030年该净需求增长路径依次为10%、8%、5%、4%、4%。GPU机头按本站AI加速器年度出货乘CPU配比。2025年约1,676万台服务器仅作整机规模对照。

基准情景:个人执行月活池中35%当天运行,所有并行及顺序沙箱合计活动90分钟、平均占1核;企业任务基础活动240分钟、占2核,可拆分任务比例30%、平均3个分支、分支相对活动量45%,协调额外核时10%。2025—2030年沙箱与后训练池每颗CPU的有效核心从128升至192,科研池另设较低的可调度核心;GPU机头平均配比由0.30升至0.35颗CPU/加速器。执行池每年采购=新增装机+满四年设备更新,2025年存量按四个等额年龄批次作起点。

个人智能体的并发高峰,是池化之后仍要保留的CPU容量

2030年基准情景高峰约12,551万个同时执行会话;单颗CPU可承载多少会话,直接改变年度采购。

基准情景以2030年年均执行月活约25.5亿人、其中35%当天运行、所有沙箱合计活动90分钟、峰均比2.25倍估算,高峰约12,551万个同时执行会话。按每颗CPU最多服务25个会话,至少需要约502万颗已部署CPU容纳高峰。

Cloudflare曾以每颗CPU服务25—50个会话作规模演算,英伟达Vera机柜的特定设计约88个环境/CPU;这些数字不能自动用于运行完整Linux云电脑和多个子任务的个人智能体。图中另设每颗仅服务10个高负载会话的情景。模型同时计算核时与高峰容量,采用两者较高的装机值,再加当年更新。

个人智能体CPU采购:2025基点与2030并发容量情景

横轴为单颗CPU在高峰可同时服务的执行会话数

2025年拟合采购2030年年度采购
悬浮或点选查看;键盘可逐期查阅
个人智能体CPU采购:2025基点与2030并发容量情景;左轴:百万颗服务器CPU / 年
期间2025年拟合采购2030年年度采购
10会话/颗0.00257.22
25会话/颗0.00252.12
35会话/颗0.00251.37
50会话/颗0.00250.8816
88会话/颗0.00250.5972

每种容量限制均沿2025—2030年完整用户与更新路径重新计算,且与活动核时所需容量取较大值。Cloudflare以25—50会话/CPU作规模演算,英伟达Vera特定设计约88环境/CPU;10为复杂沙箱高负载压力情景,基准情景取25。

查看图表数据
个人智能体CPU采购:2025基点与2030并发容量情景;柱/左轴:百万颗服务器CPU / 年
时期 / 项目2025年拟合采购2030年年度采购
10会话/颗0.00257.22
25会话/颗0.00252.12
35会话/颗0.00251.37
50会话/颗0.00250.8816
88会话/颗0.00250.5972

AI科研长时间占核,池化效率低于短时智能体沙箱

基准情景2030年每天约1,000万项科学软件任务,对应年度CPU采购119万颗。

OpenAI披露2026年每周约130万人用ChatGPT做高级科学和数学工作,但消息不等于真实软件作业。联合国教科文组织的研究人员密度换算全球约1200万全职等效研究人员。共同基线假设到2030年约600万人每周实际运行AI科研工具、平均每人每周约12项独立代码、仿真或验证作业,折合每天约1,000万项;所选情景调整后为1,000万项。这是采用率与使用强度的预测,不是已发生的全球任务统计。

每项平均180活动分钟×32物理核,是按轻、中、重任务加权后的核时:可理解为约一半作业运行1小时×8核、四成运行3小时×32核、一成运行8小时×64核。OpenAI约一万个科研智能体并行多日、Anthropic数千条命令及Google自动评测数千代码变体,说明长尾高负载真实存在;案例没有披露足以证明全球采用率的CPU颗数。模型再计峰值和科研池较低的可调度核心,推到119万颗年度采购。

AI科研CPU年度采购的计算链
012025基点

每日10万项实际工具任务,年度约1.0万颗CPU

拟合起点
022030任务

每日1,000万项,每项180分钟、32核心

研究情景
03并发容量

峰均2.5倍、高峰目标利用率38%,每颗可调度128核

装机206万颗
04当年采购

由装机增加量及到期设备更新,形成年度CPU需求

119万颗/年

AI科研任务指实际运行代码、验证和专业软件的一次工具作业,不是研究人员数量;任务规模、核时和高峰目标利用率均为研究假设。

后训练和评测需要跨模型项目配置CPU环境池

2025年拟合年度采购已约2.0万颗;到2030年基准情景约25万颗,而不是只为单个模型留少量CPU。

斯坦福大学AI Index记录2025年约95个公开的显著AI模型发布,尚未包含大量小模型和内部评测。模型因此从2025年250个“活跃项目等效”与每项目每日30万次环境运行开始,得到全球每日约7,500万次;2030年共同基线取1,000个项目等效、每项目每日80万次,所选情景调整后为每日80,000万次。项目等效是规模假设,不能把95个发布直接当250个已建CPU集群。

DeepSeek已部署多个弹性计算规模单元,单个单元约3万个物理核心、每日创建约300万个沙箱。它证明训练环境数量可很大,也显示轻量沙箱能通过暂停和复用节省大量CPU。本模型每次环境运行按50物理核分钟计入较重的代码、浏览器、评测和评分工作,高于DeepSeek轻量实例的单次活动核时;因此后训练需求对任务组合与池化效果敏感。

后训练CPU需求:项目、环境运行与装机
01项目广度

2025年250个、2030年1000个活跃项目等效

研究情景
02每日运行

每项目分别约30万至80万次/日

2030年80,000万次/日
03加权核时

每次25活动分钟×2核,再计峰均与容量余量

沙箱 + 评测
04年度采购

装机新增 + 到期设备更新

约25万颗/年

“等效活跃项目”把大小模型线及评测任务换成共同工作量,不等于公开模型仓库数;每次核时代表较重作业的加权假设。

复杂云沙箱与更重科研任务会抬高CPU采购

若个人智能体每颗CPU最多承载10个高负载会话、AI科研单任务核时翻倍,基准情景2030年供需覆盖率为83.3%。

云端快照能释放等待中的CPU,但同时执行多个浏览器、代码或子任务的沙箱需要保留核心、内存与启动余量。媒体观察到Meta Muse的完整Linux云电脑配置约2个虚拟CPU和8GB内存;这说明它与短时轻量工具环境的资源形态不同。

若单颗CPU在高峰最多同时服务10个较重沙箱,2030年个人智能体年度采购约722万颗。若AI科研每项任务的CPU核时再翻倍,科研年度采购约241万颗;两项联动令总需求达到5,652万颗,供给仍为4,708万颗。

个人智能体与AI科研高负载下的CPU供需:基准情景

2025年基点、2030年所选情景与高负载情景;同一供给路径

年度采购需求有效交付供需覆盖率
悬浮或点选查看;键盘可逐期查阅
个人智能体与AI科研高负载下的CPU供需:基准情景;左轴:百万颗服务器CPU / 年;右轴:供需覆盖率(%)
期间年度采购需求有效交付供需覆盖率
基点25.0225100%
所选50.247.0894%
高负载56.5247.0883%

高负载情景自2026年起逐年重算:个人智能体高峰最多10个执行会话/CPU,AI科研单任务CPU核时为所选情景的2倍;用户、任务数量、其他五类需求和供给路径不变。

查看图表数据
个人智能体与AI科研高负载下的CPU供需:基准情景;柱/左轴:百万颗服务器CPU / 年;折线/右轴:供需覆盖率(%)
时期 / 项目年度采购需求有效交付供需覆盖率
基点25.022599.9%
所选50.247.0893.8%
高负载56.5247.0883.3%

每颗CPU可调度核心数决定同样任务需要多少芯片

高核心数产品扩产可以缓和颗数缺口,但内存与带宽会限制能真正并行的任务。

模型让新建沙箱执行池单颗CPU的有效核心从2025年128升至2030年192。英特尔与高通已发布更高核心数产品路线,采购量还取决于内存容量、带宽和软件是否能把核心排满。

科研软件常连续占用多个核心、保留整节点,并非能与短时个人智能体任务达到同样池化率;模型为AI科研单设较低的可调度核心数与利用率。

执行池年度CPU采购:2025基点与2030核心密度情景

2030年三种有效核心数;横线为2025年四类执行池合计

2030年年度采购2025年拟合基点
悬浮或点选查看;键盘可逐期查阅
执行池年度CPU采购:2025基点与2030核心密度情景;左轴:百万颗CPU / 年
期间2030年年度采购2025年拟合基点
128核/颗5.790.0527
192核/颗4.960.0527
256核/颗4.550.0527

个人、企业、AI科研与后训练四类。只改变2030年执行池有效核心数,2025年基点单列为横线;科研池采用自己的可调度核心数,不随沙箱核心情景机械改变。

查看图表数据
执行池年度CPU采购:2025基点与2030核心密度情景;柱/左轴:百万颗CPU / 年
时期 / 项目2030年年度采购2025年拟合基点
128核/颗5.790.0527
192核/颗4.960.0527
256核/颗4.550.0527

AI科研的长任务与个人智能体的并发高峰各占一部分需求

一万名科研智能体并行运行和数千万个人智能体在云端执行,形成两种不同的CPU容量压力。

OpenAI约一万个并发科研智能体运行约88小时、处理270万条消息,表明科研任务可在短时间形成密集的代码、形式化验证和工具执行。Anthropic亦披露数十个智能体协作多日、运行数千条命令。这些案例支撑单任务高强度的设定,但全球每日任务量仍需持续验证。

个人智能体的容量同时取决于CPU活动核时与高峰可容纳的沙箱数。即便平均运行时间短,当数千万用户在相近时段发起任务,单颗CPU可承载的会话、内存和隔离开销会先成为约束。

机头之外五类AI工作:2025基点与2030年度CPU采购

每类均含已建容量更新及新增采购;所选需求情景

2025拟合基点2030研究情景
悬浮或点选查看;键盘可逐期查阅
机头之外五类AI工作:2025基点与2030年度CPU采购;左轴:百万颗CPU / 年
期间2025拟合基点2030研究情景
个人智能体0.00252.12
企业智能体0.01961.41
AI科研0.01031.19
后训练0.02030.2481
其他AI0.752.29

科研任务量与强度、个人智能体高峰并发,以及其他AI去重代理量均为研究情景。五类主要是GPU机头之外的执行负载,实际可分布于专用CPU机柜或普通云服务器。

查看图表数据
机头之外五类AI工作:2025基点与2030年度CPU采购;柱/左轴:百万颗CPU / 年
时期 / 项目2025拟合基点2030研究情景
个人智能体0.00252.12
企业智能体0.01961.41
AI科研0.01031.19
后训练0.02030.2481
其他AI0.752.29
07
CPU SUPPLY

新制程扩产增加CPU供应,先进晶圆仍要与AI芯片共享

英特尔、AMD和台积电的新产能在2026—2028年逐步爬坡;一颗CPU最终能交付,还取决于良率、封装、内存和整机配套。

2030年可交付约4,708万颗,芯片与配套成为直接约束

先进晶圆仍有一定余量,芯片量产与配套决定可交付数量。

2025年以服务器CPU销量范围、Arm和其他供应商参与度校准交付起点。此后独立估计英特尔Intel 3/18A、AMD在台积电N2/N3的新产品、封装和内存配套逐年形成的有效交付量;TrendForce的整机增速用于交叉观察需求,不能直接代入芯片供给。

2030年芯片及配套路径约4,708万颗,扣除GPU和专用芯片等效占片后的先进晶圆路径约5,459万颗。先进晶圆能力多出约752万颗理论空间,直接瓶颈在芯片及配套。GPU芯片面积、良率与共享池释放会改变两者的相对位置。

2025—2030年CPU需求与两条供给能力

芯片及配套有效交付、先进晶圆容量取较低值

芯片及配套交付能力先进晶圆容量上限CPU年度需求
悬浮或点选查看;键盘可逐期查阅
2025—2030年CPU需求与两条供给能力;左轴:百万颗服务器CPU / 年
期间芯片及配套交付能力先进晶圆容量上限CPU年度需求
2025基准2542.7825.02
2026E2746.5830.01
2027E30.2451.9735.42
2028E36.8967.3139.55
2029E42.862.8944.51
2030E47.0854.5950.2

2025年为拟合基点,后续芯片交付能力独立于服务器整机出货预测;先进晶圆容量从可共享晶圆池扣除GPU与专用芯片等效占片后换算。每年有效交付取两条能力中较低值。

查看图表数据
2025—2030年CPU需求与两条供给能力;柱/左轴:百万颗服务器CPU / 年
时期 / 项目芯片及配套交付能力先进晶圆容量上限CPU年度需求
2025基准2542.7825.02
2026E2746.5830.01
2027E30.2451.9735.42
2028E36.8967.3139.55
2029E42.862.8944.51
2030E47.0854.5950.2

2027—2028年新工艺可能缓解缺货,释放速度决定转折点

试产、产品发布和稳定量产不是同一个时点;高核心数CPU仍可能晚于工厂投产才充分供货。

英特尔2026年财报披露服务器需求仍超过其供应;18A-P于当年6月进入风险试产,同时计划扩建爱尔兰Intel 3产能。AMD Venice在台积电N2进入生产爬坡;台积电新增N3产能将于2027—2028年分批投产。

上述进度解释为什么供给改善需要时间,也为何不能将试产月份直接算作当年大量成品CPU。AMD预计自身2027年供应好于2026年,但全球供需还取决于智能体任务量及其他AI芯片占片。

服务器CPU扩产与交付时间轴
012025—2026

英特尔披露服务器需求超过供给;部分型号交期延长

当前紧张
022026

AMD Venice在台积电N2爬坡;英特尔18A-P风险试产

新产品起步
032027

台积电台南新N3厂预计上半年量产,亚利桑那第二厂预计下半年量产

新增晶圆
042028以后

台积电日本第二厂预计量产;18A、Intel 3与配套交付仍需兑现

继续释放

公司披露的是工厂和产品进度;服务器CPU年度有效交付另受芯片分配、良率和配套约束。

扩产兑现速度会改变2030年的供需平衡

新节点的良率、可分配晶圆及封装配套若提前或延后,数年累积会放大供给差异。

新工艺试产后还要提升良率,取得载板、封装和内存,并形成客户可以收到的产品。因此即使晶圆厂宣布扩建,2030年CPU有效交付仍存在较大范围。

图中每根柱都与需求横线比较,并保留2025年起点;如果芯片交付增长慢于智能体任务核时,供需覆盖率下降。相反,18A、Intel 3和台积电先进工艺如期释放,可逐步缩小缺口。

2030年CPU有效交付的增速敏感性

柱为不同芯片交付增速对应的2030年结果;横线为需求与2025年交付基点

2030年有效交付2030年需求2025年拟合交付
悬浮或点选查看;键盘可逐期查阅
2030年CPU有效交付的增速敏感性;左轴:百万颗服务器CPU / 年
期间2030年有效交付2030年需求2025年拟合交付
10%/年40.2550.225
16%/年47.250.225
22%/年54.5950.225

以2025年拟合交付为基点,2028—2030年芯片有效交付增速作敏感性变化;每种路径均接受先进晶圆上限检验。横轴增速为研究情景,不是厂商指引。

查看图表数据
2030年CPU有效交付的增速敏感性;柱/左轴:百万颗服务器CPU / 年
时期 / 项目2030年有效交付2030年需求2025年拟合交付
10%/年40.2550.225
16%/年47.250.225
22%/年54.5950.225

服务器CPU扩产要与GPU、专用芯片争取先进晶圆

先进制程总产能扩大时,各类芯片仍会竞争同一时期的投片与封装资源。

台积电在2026年第二季度业绩会上指出,智能体让CPU在AI数据中心重新受到重视,并带来加速器之外的硅片需求。公司正扩建3纳米工厂,同时表示一项新工艺从开发到充分爬坡往往需要五年以上。

晶圆厂宣布扩建到实际可投片,还要取得量测、检测等关键设备;一线交流提示设备交付可能拖慢爬坡。台积电公布的节点份额主要是晶圆收入份额,没有公开2030年先进节点绝对投片数、GPU与专用芯片占用量、CPU配额和良率。因此全球CPU可交付量只能是条件情景。

先进工艺的分配顺序
01节点可投片

2/3/5纳米等工艺逐步扩产

总池未知
02其他产品占用

GPU、专用芯片与手机等分走不同节点

必须扣除
03CPU可用片数

再乘良率与每片合格芯粒数量

仍受封装约束

台积电2025总产能超过1700万片12英寸等值晶圆,涵盖所有工艺,不能作为上图的先进制程总池。

高核心数采购提高CPU对先进制程的依赖

2030年基准情景中,约86%服务器CPU封装需要先进计算芯粒;这一比例由七类需求的产品组合加权得到。

传统服务器仍包含较低核心数与旧平台,模型中的先进工艺占比由2025年40%升至2030年80%;GPU机头由85%升至95%;智能体、AI科研和后训练执行池由90%升至100%;其他AI负载由60%升至80%。每类采购颗数变动后,行业占比随之重新计算,不再固定取60%。

CPU封装可以把先进计算芯粒与较成熟的输入输出芯粒组合,并非整颗芯片只有一个制程。高核心产品通常需要更多计算芯粒或更大面积;晶圆换算同时让每片合格封装数按传统、机头、执行池分别下降,2030年混合等效值约58颗/片。这些是面积与良率的情景参数。

2025—2030年CPU需求中的先进工艺占比

堆叠柱为当年CPU采购结构;折线为先进计算芯粒占比

含先进计算芯粒的CPU其余CPU先进工艺占比
悬浮或点选查看;键盘可逐期查阅
2025—2030年CPU需求中的先进工艺占比;左轴:百万颗服务器CPU / 年;右轴:含先进计算芯粒比例(%)
期间含先进计算芯粒的CPU其余CPU先进工艺占比
2025基准11.7913.2347%
2026E17.0612.9557%
2027E23.2412.1966%
2028E28.8610.6973%
2029E35.628.8980%
2030E43.416.7886%

按传统业务、GPU机头、四类执行池和其他AI采购颗数,分别乘每年的先进计算芯粒占比后加权;芯粒其他部分仍可能使用成熟工艺。2025年为拟合结构,2026—2030年为研究假设。

查看图表数据
2025—2030年CPU需求中的先进工艺占比;柱/左轴:百万颗服务器CPU / 年;折线/右轴:含先进计算芯粒比例(%)
时期 / 项目含先进计算芯粒的CPU其余CPU先进工艺占比
2025基准11.7913.2347.1%
2026E17.0612.9556.8%
2027E23.2412.1965.6%
2028E28.8610.6973.0%
2029E35.628.8980.0%
2030E43.416.7886.5%

先进晶圆扩产为CPU留出空间,覆盖程度因需求而变

GPU与专用芯片出货上升,会先占用共享先进工艺;CPU剩余空间还受单颗面积和良率影响。

供给情景设2025年可由加速器与服务器CPU共用的先进晶圆约每月5万片,逐步增至2030年17.0万片;这些是研究假设,不是晶圆厂公告。同期本站总量模型预计AI加速器年度出货由1190万颗增至4310万颗,先占用其中一部分晶圆。

图中红线是所选需求情景下CPU需要的先进晶圆。若红线高于绿色剩余部分,晶圆情景将压低可交付CPU数量。这个判断特别受加速器面积、良率和CPU先进工艺份额影响,不能把台积电收入增长直接当晶圆增长。

2025基点至2030年先进晶圆分配情景

柱:加速器所需晶圆与扣除后的CPU余量;折线:CPU需求所需

GPU与专用加速器所需扣除后可供CPUCPU需求所需晶圆
悬浮或点选查看;键盘可逐期查阅
2025基点至2030年先进晶圆分配情景;左轴:千片12英寸等效晶圆/月
期间GPU与专用加速器所需扣除后可供CPUCPU需求所需晶圆
2025基准28.3321.6712.67
2026E45.2529.7519.17
2027E64.7940.2127.41
2028E74.0560.9535.81
2029E88.3366.6747.19
2030E102.6267.3861.95

共享先进晶圆池2025—2030年依次设50/75/105/135/155/170千片/月,已排除手机等其他用途;加速器2030年按每片35颗合格封装换算。均为研究参数。

查看图表数据
2025基点至2030年先进晶圆分配情景;柱/左轴:千片12英寸等效晶圆/月
时期 / 项目GPU与专用加速器所需扣除后可供CPUCPU需求所需晶圆
2025基准28.3321.6712.67
2026E45.2529.7519.17
2027E64.7940.2127.41
2028E74.0560.9535.81
2029E88.3366.6747.19
2030E102.6267.3861.95

加速器占片增多,会迅速压缩CPU可用晶圆

同样的GPU与专用芯片出货,单颗面积和良率不同,留给CPU的晶圆可差很多。

本站总量模型预计2030年AI加速器出货约4,310万颗。若每片晶圆能形成35颗合格加速器封装,年需求折合约102.6千片等效晶圆/月;再假设多厂先进工艺中、已排除手机等用途后,可供加速器和服务器CPU共用170千片/月,剩余约67.4千片/月。这个共享池是研究参数,不是台积电公告。

当前需求结构中约86%的CPU使用先进计算芯粒,按产品面积与良率折合每片约58颗合格CPU封装,需要约62.0千片/月。加速器面积、良率和不同CPU的组合会改变分配压力。

2030年加速器单片产出变化对CPU晶圆余量的影响

横轴为每片等效晶圆的合格加速器封装数;水平线给出2025研究基点

加速器所需剩余可分配2030年CPU所需2025年CPU可用余量情景
悬浮或点选查看;键盘可逐期查阅
2030年加速器单片产出变化对CPU晶圆余量的影响;左轴:千片等效晶圆/月
期间加速器所需剩余可分配2030年CPU所需2025年CPU可用余量情景
25颗/片143.6726.3361.9521.67
35颗/片102.6267.3861.9521.67
45颗/片79.8190.1961.9521.67

2025年水平线来自当年5万片/月共享池及加速器出货的研究基点;2030年共享池设170千片/月,已排除手机等用途。所选情景中CPU先进芯粒占比86%、每片约58颗合格CPU封装。

查看图表数据
2030年加速器单片产出变化对CPU晶圆余量的影响;柱/左轴:千片等效晶圆/月
时期 / 项目加速器所需剩余可分配2030年CPU所需2025年CPU可用余量情景
25颗/片143.6726.3361.9521.67
35颗/片102.6267.3861.9521.67
45颗/片79.8190.1961.9521.67

交期与供给改善可能同时发生在不同产品线上

2026年缺货是真实线索,2027年改善也是机构预期;产品和时间需要分开看。

英特尔披露2026年第二季度服务器数量同比增长9%,需求高于可供货量;48%的平均售价增幅主要来自高端产品组合,而非同规格普遍涨价。公司预计基板、内存等供给约束仍可能跨入2027年。

TrendForce在2026年4月观察到部分一般服务器关键物料交期接近一年,7月又预计CPU与内存供应可能在2027年改善。专家访谈提示,交期缩短也可能由前期备货或新增订单放缓造成。交期、新订单与实际交付需要一起观察,才能分辨供给改善和需求转弱。

从晶圆到交付的四道关
01晶圆

先进节点分配与芯粒良率

02封装

高密度载板、ABF载板绝缘膜和组装

03整机

内存、网络和电源配齐

04部署

云平台上线并达到目标利用率

任一环节短缺都能延后CPU服务器交付;CoWoS是面向高端AI芯片的先进封装,不能把其产能直接当CPU晶圆片数。

CPU供给还受先进晶圆分配影响

GPU与专用芯片也使用先进产能;CPU可分得的晶圆与每片良品数共同决定潜在交付。

台积电2025年先进工艺收入占晶圆收入74%,2026年第二季度2、3、5、7纳米的晶圆收入占比分别为3%、30%、33%、11%;这是收入,不是晶圆数。本站总量模型虽预测先进制程收入由2025年的90.6十亿美元增至2030年的257.1十亿美元,也无法直接给出CPU分配额。

右图改变“排除其他产品后可供加速器与CPU共享的先进晶圆池”。共享池越小,或加速器芯片面积越大、良率越低,CPU剩余空间就越窄;英特尔自有制造、三星代工和新节点爬坡可改变边界。当前没有足够公开资料把图中任一柱确认为2030年实际供应。

先进晶圆共享池:2025基点与2030分配情景

2030年不同共享池先扣AI加速器所需晶圆,再看CPU所需晶圆

2030加速器所需2030扣除后可分配CPU2030 CPU所需2025共享池基点
悬浮或点选查看;键盘可逐期查阅
先进晶圆共享池:2025基点与2030分配情景;左轴:千片12英寸等效晶圆/月
期间2030加速器所需2030扣除后可分配CPU2030 CPU所需2025共享池基点
150千片102.6247.3861.9550
170千片102.6267.3861.9550
190千片102.6287.3861.9550

横轴150/170/190千片为2030年研究情景;2025年共享池拟合基点单列为横线。若加速器所需量超过共享池,既定出货与CPU供给无法同时兑现。

查看图表数据
先进晶圆共享池:2025基点与2030分配情景;柱/左轴:千片12英寸等效晶圆/月
时期 / 项目2030加速器所需2030扣除后可分配CPU2030 CPU所需2025共享池基点
150千片102.6247.3861.9550
170千片102.6267.3861.9550
190千片102.6287.3861.9550
查看数据中心功率的数量级参照

另一组数据中心设计容量情景以2030年全球244吉瓦、其中AI相关180吉瓦为起点,得到CPU装机功率约34吉瓦、当年增加6.95吉瓦。按每颗300瓦作粗略参照,新增功率对应约2,317万颗芯片;此值尚未计更新需求,不能直接与七类年度采购相加。

这项功率参照用于检查需求数量级。设计容量、实际IT用电和芯片功耗的口径不同,年度供需仍以分项任务和有效芯片交付计算。

08
CURRENT SIGNALS

厂商供不应求、涨价和长交期印证当前景气

英特尔、Arm、AMD及中国市场的最新资料提供需求、供给和价格线索;管理层表态、媒体调查与实际交付分开标记。

CPU 产业资讯看板资料截止 2026-09-30 · 15 条可核对资讯
国际 · 英特尔供给

陈立武称英特尔目前只能满足约一半客户所需CPU ↗

英特尔高管表态:约满足50%

在9月14日Splunk .conf26与思科高管公开对谈中,英特尔CEO陈立武表示,CPU需求高到公司目前只能提供客户所需的大约50%,并称多位企业CEO因供货不足来电。报道未给出统计时段、订单定义或服务器与个人电脑的拆分。

观察意义:这是英特尔当前供货紧张的强信号,但不能当作全球服务器CPU有50%缺口,也不能外推至2030年。

高管公开表态 · 媒体报道
国际 · 英特尔景气度

英特尔二季度服务器CPU销量增9%,需求仍超过供给 ↗

2026Q2服务器数量 +9%

英特尔10-Q披露服务器产品数量同比增长9%、平均售价同比增长48%,均价上升主要来自高端产品占比提高;公司同时称服务器需求超过可供货量。48%不是同规格CPU涨价幅度。

观察意义:销量与产品结构改善有财报证据;产能、基板、内存等约束也同时存在。

已披露事实 · 公司财报
国际 · AMD供给

AMD预计自身2027年服务器CPU供应好于2026年 ↗

AMD预期:2027年自身供应改善

AMD二季度电话会称服务器CPU供应链目前紧张,部分需求超出此前预测;公司预计2027年自身供应情况好于2026年,并认为可支持服务器CPU收入增长。这是AMD的供应判断,不能直接代表全球市场已经转为宽松。

观察意义:供应改善须按年份纳入预测;2027年实际交付量仍取决于先进晶圆、封装和整机配套。

公司预期 · 公司财报
中国 · 英特尔 / AMD景气度

路透:国内部分服务器CPU年内涨价超过40%,客户商谈长期锁量 ↗

中国部分型号年内涨价>40%(路透信源)

路透援引两名知情人士称,英特尔与AMD正同中国服务器客户讨论通常约一年、部分更长的采购量承诺,价格不锁定;其中一名信源称,中国部分服务器CPU自2026年初涨价超过40%。这不是所有型号的普遍涨幅,也不是两家公司确认的合同总量。

观察意义:价格与采购条款显示局部现货紧张,需继续跟踪具体型号报价、实际交期及长约兑现。

媒体调查 · 媒体报道
国际 · 英特尔供给

英特尔18A-P进入风险试产,另投50亿欧元扩建Intel 3产能 ↗

18A-P风险试产;Intel 3扩建50亿欧元

英特尔二季度公告称18A-P进入风险试产,推出采用18A的Xeon 6+服务器CPU,并投资50亿欧元增加Xeon 6及下一代Intel 3服务器CPU产能。风险试产和投资不等于当年大规模成品交付。

观察意义:18A与Intel 3构成2027—2028年服务器CPU供给改善的潜在来源,需观察产能、良率与客户交付。

已披露事实 · 公司公告
国际 · TrendForce交期

TrendForce:一般服务器CPU等关键部件交期接近一年 ↗

部分部件交期接近一年

TrendForce称CPU及电路板等关键部件交期接近一年,服务器出货增速预测由此前接近20%调至约13%,无法充分反映潜在需求;未满足采购需求可能延续到2027年。

观察意义:整机出货受供给限制,不能直接把当年的整机出货增速当作CPU需求增速。

机构预测 · 行业机构原始研究
主要厂商对CPU前景的公开表态 · 8家
截至2026-09-30的公开表态;产品路线与已实现需求分开标记
企业CPU判断与布局证据状态
英特尔 ↗2026-09-14陈立武9月公开称当前仅能满足约一半客户所需CPU;二季度财报也披露服务器需求超过可供货量。50%未拆分服务器与个人电脑。高管公开表态与公司财报
AMD ↗2026-08-04目前服务器CPU供应链紧张,预计自身2027年供应好于2026年;智能体沙箱是公司2030年市场空间展望的重要部分。公司供应与市场预期
英伟达 ↗2026-05-31Vera既作为Vera Rubin主机,也建设独立CPU机柜,面向智能体执行、强化学习和数据处理。产品定位;系统上市为预期
Arm ↗2026-07-29自有AGI CPU初期产品已交付;2027至2028财年客户需求超20亿美元,现有锁定制造产能支持10亿美元机会,并在继续扩产。公司需求与产能披露
高通 ↗2026-06-24Dragonfly C1000规划智能体、通用计算、加速器机头三类CPU,计划2028年商用。产品路线预期
亚马逊云 ↗2026-04-24Meta计划在多种AI相关负载中部署从数千万Graviton核心起步的云CPU资源。已公告协议;部署规模为计划起点
阿里巴巴 ↗2026-09-25倚天720/730按智能体任务规划,预计2027年推出;现有倚天710已用于云实例。产品路线预期
海光信息 ↗2026-08-14持续迭代CPU及深度计算处理器;财报没有单列CPU收入或销量,不能把公司整体增长直接当作CPU增长。公司财报披露
09
VALUE CHAIN

CPU机会分布在芯片、封装、网络与云端执行

供需紧张能否变成企业收入,取决于CPU出货、配套部件交付、软件适配和云端任务部署。

供需趋紧时,机会先落在能交付的CPU平台与关键配套

订单增长要经过芯片产能、软件适配和整机上线,才能变成收入。

英特尔与AMD已经拥有大量服务器客户,紧缺时更容易通过高端产品组合和交付量体现需求;英伟达Vera、Arm AGI CPU与高通Dragonfly则争取新建智能体机柜和GPU机头。产品发布只是起点,晶圆、封装、软件和客户验收决定新增份额能否兑现。

国产CPU的机会在政企与云平台的工作负载适配,无法用海外缺口直接推算。制造、载板与内存企业可能受益于更复杂的服务器配置;云厂商则要把CPU采购变成可计费的任务执行,并用快照与池化控制成本。观察实际出货、客户订单和毛利率,比只看核心数或市场规模预期更有效。

产业链观察框架
位置代表公司兑现条件
服务器CPU英特尔、AMD、英伟达、Arm、高通晶圆配额、量产良率、客户部署与售价
国产替代海光信息、飞腾、阿里云倚天操作系统与软件兼容、产品供给、云实例采用
制造与封装台积电等晶圆厂、载板与封装供应商先进节点投片、封装和内存配套兑现
云执行亚马逊云、阿里云等活动核时增长、池化效率和单位任务成本

公司仅用于说明产业链位置;收入、利润和估值不能按CPU出货倍数直接外推。

国产CPU已有多条服务器路线,替代能力要看系统适配

海光、飞腾和阿里云倚天处在不同的软件生态与采购位置。

国产CPU并非单一路线。海光信息的服务器CPU用于云计算等通用场景;飞腾腾云S5000C兼容Armv8并支持硬件虚拟化,产品页列有16、32、64核版本;阿里云倚天710已用于云实例。它们都可能服务AI服务器或执行环境,但硬件指令、软件生态和采购主体不同。

云端智能体能否迁移,还要看操作系统、容器镜像、第三方库、编译工具与加速器连接。阿里云的迁移文档明确要求对x86应用重新编译和做兼容测试。因此国产采购机会须逐项验证工作负载、量产供给及客户部署,不能由海外CPU紧缺直接推算。

国产服务器CPU的三种可核对路径
01海光信息

面向通用服务器、数据库和云计算的CPU产品系列

服务器产品
02飞腾腾云

Armv8兼容的16至64核S5000C,支持硬件虚拟化

AI服务器适配
03阿里云倚天

倚天710已作为云实例提供,迁移x86程序需适配

云服务自用

三种产品的核心、指令架构和销售方式不同;无法从产品页推出2030年市场份额、晶圆配额或全球CPU缺口中的替代数量。

x86、Arm与RISC-V争夺的是系统效率和软件生态

单看核心数或指令集,都不足以判断最终采购份额。

英特尔至强和AMD EPYC覆盖广泛的x86服务器软件;亚马逊云Graviton、Google Axion、阿里云倚天及英伟达Vera走Arm路线;RISC-V提供开放定制选择,但服务器生态仍在建设。Arm已直接推出面向智能体数据中心的自有CPU。

云厂商若自行优化芯片、系统和编译环境,可改善单位任务成本;软件迁移、兼容性、内存带宽和可交付量同样决定最终采用。

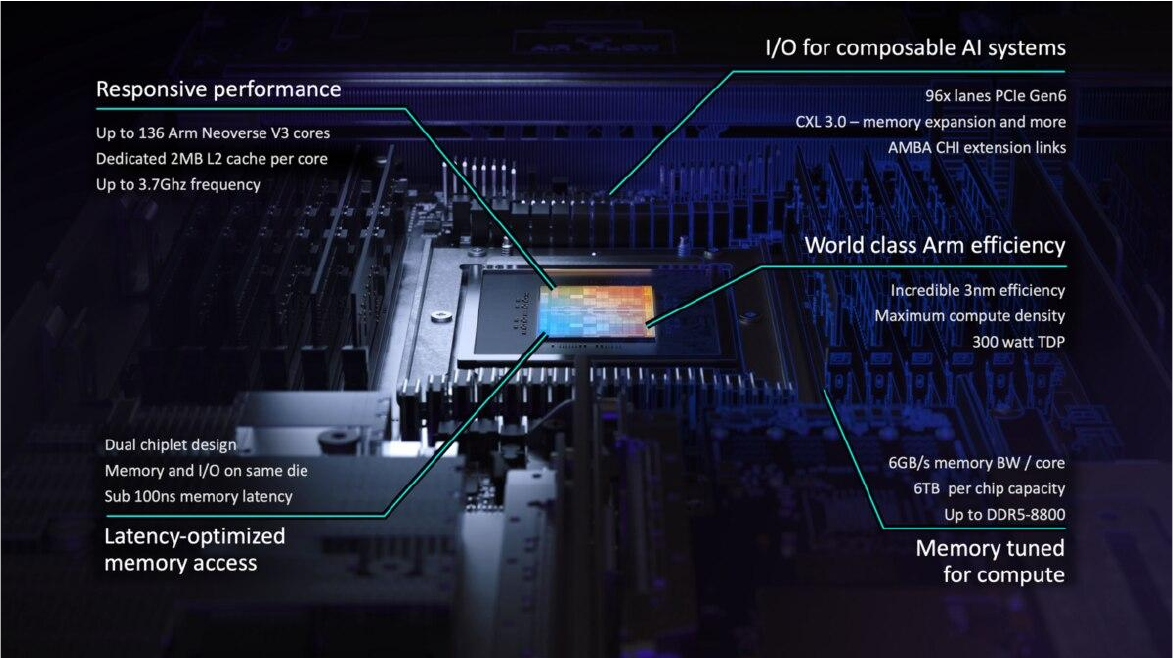
Arm AGI CPU面向独立智能体机柜的设计研究资料图表 · 点击查看原图
Arm AGI CPU产品与机柜配置图

Arm公布的自有CPU与机柜设计,面向云端智能体执行环境。

Arm生态扩张,不等于每年新增同样多颗CPU

授权、芯片设计与整机交付分处不同价值层,核心数也不是芯片颗数。

Arm向客户提供指令架构、Neoverse处理器知识产权或更完整的计算子系统,云厂商据此设计自用CPU;Arm AGI CPU则是其自有服务器芯片。三种方式取得的收入、产能责任与客户关系不同。

Arm披露截至2026年7月,Neoverse累计出货核心超过15亿,最近5亿核心约用9个月。这说明生态采用加快,但一颗CPU可含数十至上百核心,且“累计核心”覆盖多年,不能直接当作2026年芯片销量或2030年市占率。

Arm Neoverse生态的规模参照
01累计核心

截至2026年7月超过15亿个Neoverse核心

多年累计
02最近增量

最近5亿个核心约用9个月出货

采用加快
03CPU销量

每颗芯片可含数十至上百核心,芯片颗数另行统计

口径不同

以上为Arm公开的Neoverse生态核心数,不等于Arm自有AGI CPU销量。

新进入者同时瞄准机头与独立CPU池

高通等公司把智能体、通用服务器和加速器主机放入同一产品路线。

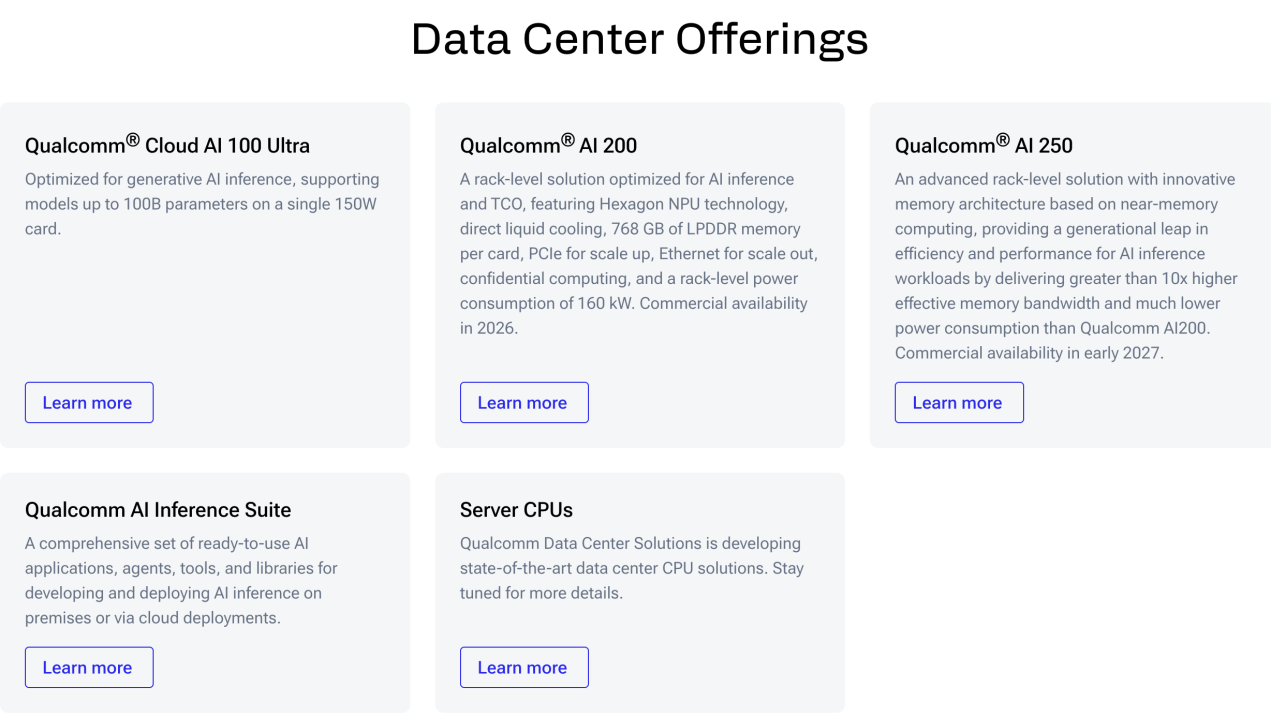
高通公布Dragonfly C1000服务器CPU路线,计划2028年商业供应,覆盖智能体执行、通用计算及加速器机头。与Arm自有AGI CPU、英伟达Vera等产品一样,它显示CPU市场可能从既有x86双寡头向更多系统方案扩展。

设计能力、量产良率、软件迁移和云客户采购决定最终份额。产品路线图不等于2028年的销量,更不能把匿名传闻中的订单计入供给。

高通公布的数据中心CPU与加速器产品布局研究资料图表 · 点击查看原图
高通数据中心路线示意,包含独立CPU、AI加速器与系统互连

Dragonfly C1000计划2028年商用,覆盖通用计算与智能体执行。

高核心密度也提高载板、内存和封装的重要性

一颗CPU能容纳更多核心,电力与信号仍要通过系统材料送进送出。

ABF是高性能CPU封装载板里的层间绝缘材料,帮助把越来越多的芯粒、内存和输入输出线路连接起来。更复杂的封装提高了对载板、内存和散热的要求。

国内外供应商的机会分布在CPU设计、代工、封装、整机和云平台各层。2026年海光信息收入增长较快,但公开财报没有把CPU与深度计算处理器收入完全拆开,不能把公司收入增速当作CPU行业销量。

CPU出货兑现链
01芯粒制造

先进与成熟制程按产品组合使用

02封装载板

ABF层间绝缘膜支持细线连接与多层布线

03服务器

内存、网卡、散热与供电完成整机

04云服务

以活动核时与单位任务成本兑现采购

材料紧缺会拖延整机交付,但不能把载板收入、CPU收入与云收入相加为同一个市场。

高阶载板供给缺口可能限制高核心CPU交付

CPU、GPU和AI交换芯片共同争夺大尺寸、多层布线的封装载板。

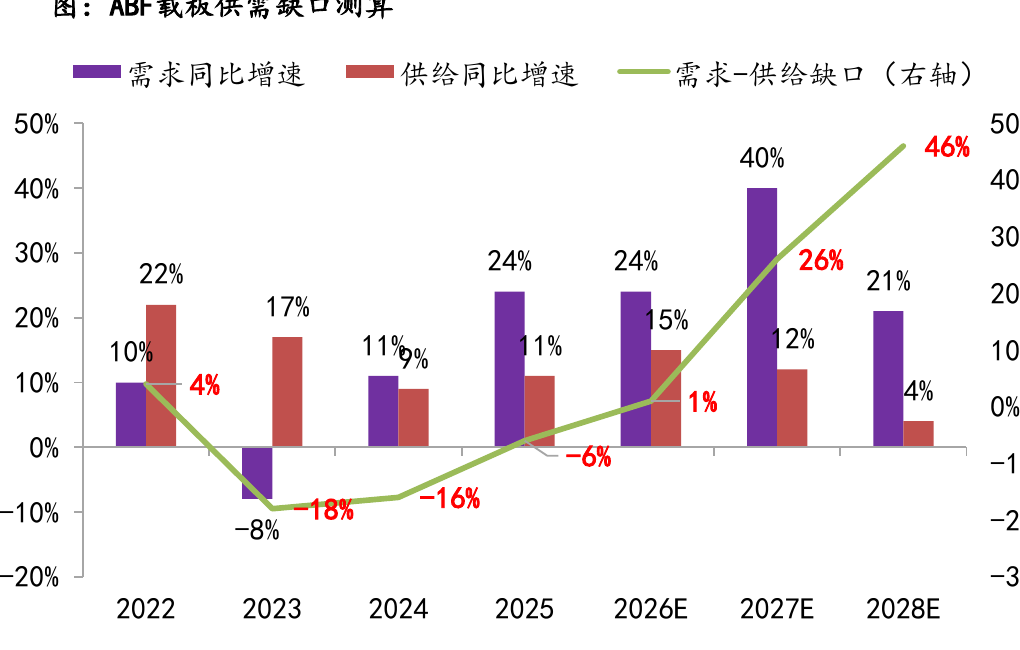
载板连接CPU芯粒与主板。核心数、芯粒数量和输入输出接口增加时,载板面积、层数及良率要求同步提高。福邦证券原始预测把2025年高阶载板供需缺口估为−6%,2026—2028年分别为1%、26%和46%。高盛2026年9月更新则估计2026年下半年、2027和2028年的缺口为14%、34%和51%;两份研究时间与覆盖范围不同,显示的共同方向是供给持续紧张。

揖斐电表示,大型高层数载板需求明显超过行业产能,增量来自高端CPU、GPU和AI交换芯片。即使CPU晶圆完成,载板无法同步交付仍会拖慢成品出货;扩大载板产能所需的投资和量产时间,使这一约束可能延续到新制程爬坡之后。

ABF载板供需预测:2025基点与2026—2028年变化

柱为需求与供给年度增速;折线为预测的供需缺口

需求增速供给增速供需缺口
悬浮或点选查看;键盘可逐期查阅
ABF载板供需预测:2025基点与2026—2028年变化;左轴:年度增速(%);右轴:供需缺口(%)
期间需求增速供给增速供需缺口
2025估计2411-6%
2026E24151%
2027E401226%
2028E21446%

福邦证券原始工作表的两组增速与独立计算的供需缺口;缺口不能由同年需求增速减供给增速得到。2025年供给略多,2026—2028年为预测。缺口适用于相关高阶载板市场,并非CPU芯片短缺率。

查看图表数据
ABF载板供需预测:2025基点与2026—2028年变化;柱/左轴:年度增速(%);折线/右轴:供需缺口(%)
时期 / 项目需求增速供给增速供需缺口
2025估计2411-6.0%
2026E24151.0%
2027E401226.0%
2028E21446.0%
查看原始ABF载板供需图
高阶ABF载板供需缺口预测原图研究资料图表 · 点击查看原图
2025至2028年高阶ABF载板需求、供给和缺口预测

上方交互图按原始工作表逐项重绘;不同机构预测未拼接为单一序列。

独立CPU机柜扩张,也会拉动网卡与交换芯片

执行机柜需要把任务、模型服务和共享存储连起来,网络不能只按CPU颗数估算。

GPU机头的网络主要服务模型数据通路;独立CPU执行机柜则在每次工具调用后,还要访问GPU推理、共享文件、数据库或外部服务。多智能体并行工作会增加东西向流量,沙箱快照和恢复又增加存储流量。因此新增CPU不仅带动服务器网卡,还可能提高机架交换和数据处理器的配置要求。

英伟达Vera独立机柜展示了256颗CPU与BlueField-4数据处理器、Spectrum-X以太网的组合;英特尔E835网卡支持最高每秒200吉比特的以太网连接,博通Tomahawk 6交换芯片支持每秒102.4太比特交换容量。这些是产品规格,不是每新增一颗CPU对应多少网络芯片。投资上应跟踪机柜端口密度、每任务流量和实际交换设备出货。

一个智能体任务跨机柜运行时的网络路径
01CPU执行机柜

浏览器、代码与科研工具产生模型请求和文件读写

256 CPU示例
02网卡与数据处理器

连接主机并卸载网络、存储、安全处理

端口与吞吐
03交换芯片

汇聚多台执行服务器与GPU机柜之间的流量

机架级扩展
04GPU推理与存储

返回模型结果,并保存数据与沙箱快照

往返流量

英伟达Vera的256颗CPU机柜配置BlueField-4数据处理器及Spectrum-X以太网,是系统实例;不同部署的网卡端口数和带宽由流量决定。

10
MONITORING

后续景气取决于任务核时、资源效率与交付速度

执行量增长只有超过每颗芯片性能与池化效率提升,才会持续转化为更多CPU采购。

先看真实活动,再看服务器订单

使用人数、云沙箱数量和芯片订单之间隔着任务强度与部署效率。

需求侧跟踪当天真正执行的任务、多智能体可拆分比例、科研工具调用及强化学习环境核时。效率侧看暂停快照、资源池利用率、峰值与单芯片性能。供给侧看先进晶圆、封装基板、内存和整机交期。

如果活动核时持续增长,但芯片核心数、池化利用率和软件优化更快,CPU颗数需求可能低于任务增速;反过来,GPU与专用芯片面积增加或CPU分配不足,会让订单景气先于实际交付。

每季度更新的关键指标
01需求

执行日活、企业任务数、科研工具核时、训练环境运行

真实活动
02效率

单任务CPU分钟、暂停率、池化利用率、每核性能

CPU/任务
03交付

先进晶圆分配、CPU交期、载板/内存和实际采购

芯片/年

任务数增长而单任务核时下降时,CPU颗数不一定同比增长。

11
INTERACTIVE MODEL

调整任务量、产能与价格,查看服务器CPU供需和市场空间

七类年度采购、两条供给约束与芯片售价使用同一计算模型;修改下列参数后,报告中的图表和关键数字同步更新。

MODEL / 2026-09-30-r2

从七类采购到供给、均价与市场收入

选择研究情景或调整下方参数,首节结论、需求拆解、供给和市场空间使用同一组重新计算的结果。2025年为共同拟合起点,调整主要作用于后续年度。

当前:基准情景
2030年年度需求5,020万颗

传统、GPU机头与机头之外的AI需求合计

2030年有效交付4,708万颗

芯片及配套能力、先进晶圆上限取较低值

2030年供需覆盖率93.8%

有效交付 ÷ 年度采购需求

2030年芯片潜在需求收入1,377亿美元

各类采购颗数 × 相应成交均价

服务器CPU年度供需与覆盖率

2025年拟合基点;2026—2030年随参数变化

年度采购需求有效交付供需覆盖率
悬浮或点选查看;键盘可逐期查阅
服务器CPU年度供需与覆盖率;左轴:百万颗服务器CPU / 年;右轴:供需覆盖率(%)
期间年度采购需求有效交付供需覆盖率
2025基准25.0225100%
2026E30.012790%
2027E35.4230.2485%
2028E39.5536.8993%
2029E44.5142.896%
2030E50.247.0894%

七类采购相加为总需求。有效交付取芯片及配套能力与先进晶圆容量的较低值。

查看图表数据
服务器CPU年度供需与覆盖率;柱/左轴:百万颗服务器CPU / 年;折线/右轴:供需覆盖率(%)
时期 / 项目年度采购需求有效交付供需覆盖率
2025基准25.022599.9%
2026E30.012790.0%
2027E35.4230.2485.4%
2028E39.5536.8993.3%
2029E44.5142.896.1%
2030E50.247.0893.8%

服务器CPU芯片收入与加权成交均价

芯片层市场空间;不含整机和云服务收入

潜在需求收入同组合可交付收入加权成交均价
悬浮或点选查看;键盘可逐期查阅
服务器CPU芯片收入与加权成交均价;左轴:亿美元 / 年;右轴:美元 / 颗
期间潜在需求收入同组合可交付收入加权成交均价
2025基准292.08291.821,167.27
2026E441.86397.531,472.32
2027E617526.731,741.83
2028E808.02753.72,042.94
2029E1,057.891,017.062,376.56
2030E1,377.221,291.592,743.68

潜在收入为分项颗数与均价相乘后相加;同组合可交付收入按供需覆盖率折算,实际缺货时出货组合可能不同。

查看图表数据
服务器CPU芯片收入与加权成交均价;柱/左轴:亿美元 / 年;折线/右轴:美元 / 颗
时期 / 项目潜在需求收入同组合可交付收入加权成交均价
2025基准292.08291.821,167.27
2026E441.86397.531,472.32
2027E617526.731,741.83
2028E808.02753.72,042.94
2029E1,057.891,017.062,376.56
2030E1,377.221,291.592,743.68
全球服务器CPU整体模型 · 2025年研究拟合基点,2026—2030年研究预测;采购和交付单位为万颗/年
年份传统负载GPU机头个人智能体企业智能体AI科研后训练其他AI需求合计有效交付覆盖率加权均价
美元/颗
潜在收入
亿美元
可交付收入
亿美元
2025基准2,0653570212752,5022,50099.9%1,167292292
2026E2,27258972677943,0012,70090.0%1,472442398
2027E2,45387142401081173,5423,02485.4%1,742617527
2028E2,5761,026918322111463,9553,68993.3%2,043808754
2029E2,6791,26115710254141834,4514,28096.1%2,3771,0581,017
2030E2,7861,509212141119252295,0204,70893.8%2,7441,3771,292

调整主要参数

滑块和输入框联动。个人与企业任务、科研、机头配比、交付、晶圆以及成交均价都会重新计算2025—2030年路径。

11项可调
个人与企业智能体
%

改变个人智能体当天执行人数,2025—2026年基点保持不变。

分钟

一名当天执行用户所有顺序和并行沙箱的合计CPU活动时长。

会话/颗

并发上限越低,为内存与隔离环境保留的CPU越多。

倍

相对基准任务路径的倍数,影响企业执行池装机。

AI科研与后训练
倍

同时反映真正运行工具的科研用户和每人作业强度。

倍

相对项目数乘每项目环境运行次数的共同基线。

CPU配置与供给
颗/颗

仅计GPU及加速器系统内部的机头CPU。

倍

对基准交付路径逐年调整;最终交付仍受晶圆上限约束。

千片/月

已排除手机等其他产品,供AI加速器与服务器CPU分享。

颗/片

面积与良率等效参数;越低则加速器占用晶圆越多。

市场收入
倍

在核心数、产品组合和基准供需价格指数之外调整芯片售价。

下载与核对

Excel含本版基准与预设的可编辑公式;调整后的当前网页情景请下载 JSON,包含参数、逐年分项和核对结果。

✓ 七类需求、有效交付和芯片收入勾稽通过

下载可编辑 Excel ↓

模型版本 2026-09-30-r2。Excel对应固定发布版本;当前页面的自定义参数仅反映在网页和导出的 JSON。市场收入只计服务器CPU芯片采购,2025年为研究拟合,2026—2030年为条件预测。

12
EVIDENCE & METHOD

资料来源与测算口径

读图时请区分已发生的事实、厂商预期与未来研究情景;图表都可查看数据和原始出处。

阅读关键计算口径

物理核时=实际占用的物理核心数 × 运行时长;执行池容量同时受活动核时和高峰并发限制。年度芯片采购包含新增装机与更新,供给则为当年可交付的服务器CPU。先进晶圆分配从已扣除其他产品的共享池起算,再扣GPU与专用芯片占用。

查看全部 104 项资料
PA03 · Meta:Muse 的执行与安全架构 ↗2026-09-08 · 官方技术披露

每名用户独立 Linux 云电脑,含浏览器、存储、CPU 与内存;隔离运行单元支持工具、并发子智能体与定时任务,持久任务状态另存 Postgres,虚拟机数据持续备份。

PA07 · xAI:Grok Bot 产品文档 ↗2026-09-21(更新) · 官方产品文档

同一账号多个 Bot 共享一台持久云电脑与文件、浏览器会话;跨账号隔离,关闭本机不停止后台任务;Bot 数不能等同用户数。

PA23 · AWS:Graviton5 M9g实例正式可用 ↗2026-06-10 · 官方产品披露

较Graviton4计算性能最多提升25%;实例规格到192 vCPU。供应商特定比较,不等于所有负载提升25%。

PA27 · DeepSeek:DSec生产沙箱系统 ↗2026-09-19 · 原始论文 / 生产系统披露

单个生产规模单元约160节点、每日约300万沙箱;生产系统支持超过38万并发沙箱。针对训练/评估环境,不是消费用户实测。

C02 · Meta · Introducing Muse ↗2026-09-08 · 公司披露

独立云端虚拟机、浏览器、持久任务。产品架构不意味着每个用户独占一颗CPU。

C04 · xAI · Introducing Grok Bot ↗2026-08-11 · 公司披露

可后台运行的云电脑、企业多任务与多智能体协作;同账号云电脑共享方式见Grok Bot产品文档。

C05 · OpenAI · Introducing the Agents API ↗2026-09-10 · 公司披露

Codex管理的长期云端智能体和可执行代码、文件任务的沙箱;这是云执行采用的产品证据,不是全球CPU出货预测。

C06 · Anthropic · Claude Science ↗2026-06-30 · 公司披露

科研工作台管理分析环境、已有集群与按需算力;具体CPU采购量未披露。

C07 · DeepSeek Elastic Compute (DSec) ↗2026-09-19 · 研究论文 / 生产系统披露

一规模单元近160节点、约3万物理核和约38万峰值并发沙盒;暂停微型虚拟机可快照状态并释放运行内存。是后训练/评估系统,不能直接外推消费者。

C08 · IDC · 全球活跃智能体展望 ↗2026-01-12 · 行业预测

2030年约22.16亿是IDC对全球活跃智能体的预测,原文没有定义为每日活跃,也没有说每个智能体独占CPU核心;文章主要讨论企业数字劳动力。

C09 · VecAI · 个人智能体用户路径模型 ↗2026-09-24 · 本站研究假设

复用2026—2030年基准实际执行月活,并以本站2030年审慎/上行情景给出用户敏感性;本报告另设执行日活占比、活动核时和芯片换算。

C10 · VecAI · 全球AI产业总量供给模型 ↗2026-08-18 · 本站研究假设

复用AI加速器年度出货路径及台积电先进制程收入/资本开支作为交叉参照;先进制程收入和CoWoS月产能均不等于CPU可用晶圆。

C11 · VecAI · CPU一线调研(国信互联网与海外科技)2026-09-28 · 专家调研

第5、7—10页:柜外执行CPU与池化;2027年柜外Agent服务器CPU约100万—200万颗是受访者从其所在供应商客户与产品出发的理想情景,并非全球市场预测或订单统计。

C12 · VecAI · 北美设备龙头与先进制程扩产专家会2026-09-23 · 专家调研

受访者讨论三星2/3nm、英特尔18A的扩产规划,以及关键量测设备交付延后风险;尚未披露可分配给服务器CPU的晶圆份额、良率和芯粒面积。

C13 · AWS · Meta部署Graviton ↗2026-04-24 · 公司披露

Meta合作从数千万Graviton核心起步,覆盖多种AI相关CPU负载;不是Muse单产品销量。

C14 · AMD · 智能体CPU分工 ↗2026-07-23 · 公司技术分析

执行沙箱、高频GPU主机和通用工作负载对应不同CPU配置;产品能力不是行业平均芯片性能。

C15 · NVIDIA · Vera CPU for Agents ↗2026-05-31 · 公司产品披露

88核Vera有独立CPU服务器和GPU主机两种定位;特定产品CPU/GPU配比不宜外推全行业。

C16 · VecAI · CPU供需情景计算2026-09-30 · 研究假设与计算

七类年度需求、2025年服务器CPU芯片市场估计基点、2026—2030年分阶段有效芯片供应及先进晶圆分配构成可检查的条件情景;未来供应增长和其它架构芯片数量仍属研究假设。

C19 · TSMC · 2026年第二季度业绩 ↗2026-07 · 公司披露

资本开支、先进制程需求与节点进度;公司未在该资料披露到2030年可供服务器CPU的逐年晶圆绝对数。

C22 · DeepSeek · Engram ↗2026-01 · 研究论文

确定性记忆寻址可利用主机内存与预取;不是CPU负载必然大增的证据。

C23 · Google Research · TurboQuant ↗2026-03-24 · 公司研究披露

量化压缩减少KV缓存占用;官方速度实验在H100 GPU上进行。若压缩与检索部署在CPU主机侧才形成相应CPU计算,不能把GPU实验直接计成CPU需求。

C24 · VecAI · 2026年服务器市场与架构访谈2026-09-18 · 专家调研 / 转述

受访者转述2025年全球服务器约1,676万台、x86约1,388万台,并以1.6颗/x86服务器作换算;尚未独立获得IDC全量原始表。本模型只用作规模对照,不从整机台数推导CPU芯片供应。

C25 · IDC · 全球服务器市场 ↗2026-07-28 · 行业统计与展望

2026年一季度全球服务器支出同比增长30.7%,数量同比增长3.3%;非加速服务器短期受DRAM/NAND供应约束。季度数据不能直接年化为全年芯片产能。

C26 · Intel · Xeon 6+产品规格 ↗2026-Q2 · 公司产品规格

Clearwater Forest产品表包含最多288核心的服务器CPU。具体客户部署与量产良率不能由核心数反推。

C28 · 海光信息 · CPU产品系列 ↗2026-09(查阅) · 公司产品资料

公开产品页列出服务器与云计算用途;本报告不把其旧规格当2026年最新市场份额。

C31 · 味之素 · ABF封装绝缘膜 ↗2026-09(查阅) · 材料企业技术说明

ABF为高性能CPU封装载板的层间绝缘材料,支撑细线互连;它不直接决定服务器CPU颗数。

C32 · Arm · AGI CPU产品发布 ↗2026-03-24 · 公司产品披露

Arm推出面向智能体数据中心的自有服务器CPU;其机柜性能说法来自公司特定对比,不能外推全行业。

C33 · OpenAI · Navier–Stokes千年难题研究 ↗2026-09-08 · 公司研究披露

约1万个并发智能体、约88小时获得解析证明,另17小时Lean形式化;2.7百万条消息和约1300亿输出token。未披露CPU颗数、物理核心或独立沙箱数量。

C34 · Anthropic · 黎曼ζ函数科研任务 ↗2026 · 公司研究披露

约60个子智能体协作1.5天、运行2400条shell命令和数百Python脚本;对已知零点的一个比例下界作出改进,未证明黎曼猜想。

C35 · Anthropic · 费马大定理形式化 ↗2026 · 公司研究披露

数十智能体协作11天,将已知定理形式化为Lean证明,生成与检验大量中间定理;不是新数学定理发现。

C37 · Anthropic · 多智能体安全研究实验 ↗2026 · 公司研究披露

45个协同智能体在各自虚拟机中运行,另有裁决智能体;展示多虚拟机执行结构,任务差异使结果不能直接用于CPU采购量外推。

C39 · 英特尔 · 2026年第二季度10-Q ↗2026-07-23 · 公司财报

服务器数量同比增长9%,均价同比增长48%主要因高端产品组合;需求超过供给,基板与内存等约束仍在。

C40 · NVIDIA · Vera CPU机柜设计 ↗2026-03 · 公司产品披露

256颗Vera CPU的独立机柜宣称可维持超过22500个并发智能体沙箱;是特定机柜、沙箱规模与厂商声明,不是每颗CPU平均承载数。

C41 · 台积电 · 2025年年报 ↗2026 · 公司财报

2025年总产能超过1700万片12英寸等值晶圆,实际出货约1500万片;涵盖所有工艺,不能把总量当先进制程或CPU可得晶圆。

C42 · Google DeepMind · AI co-scientist ↗2025 · 公司研究披露

科研多智能体系统分生成、反思、演化、排名、聚类和综评等角色,并与实验验证连接;不是已披露CPU采购量。

C43 · Google Research · Empirical Research Agent ↗2026 · 公司研究披露

自动生成与评测数千代码变体,用于六类科学及数值研究问题;代码运行和评测形成CPU执行需求,但未披露硬件数量。

C44 · Google Research · 多智能体扩展规律 ↗2026 · 公司研究披露

控制实验显示可并行任务中多智能体可能增益,强顺序任务中也可能降低表现;不能把所有任务按固定子智能体倍数放大。

C45 · 阿里巴巴 · 2026云栖大会发布 ↗2026-09-25 · 公司披露

公司称模型在芯片设计实验中持续60余小时并调用电子设计自动化工具逾1万次;是厂商单例,不是行业CPU出货统计。

C47 · OpenAI · ChatGPT for Academic Researchers ↗2026-07 · 公司披露

每周约130万人使用ChatGPT做高级科学与数学相关工作,约840万条消息;是产品使用数据,未披露运行工具或CPU核时比例。

C48 · 飞腾 · 腾云S5000C服务器CPU ↗2026-09(查阅) · 公司产品资料

S5000C提供16、32、64核版本,兼容Armv8,支持硬件虚拟化,面向计算、存储和AI服务器;产品规格不代表出货量或可供AI执行池的产能。

C49 · TrendForce · 智能体场景CPU/GPU配置变化 ↗2026-04-14 · 研究机构预测

预期部分智能体部署的CPU:GPU配置从1:4—1:8趋向1:1—1:2;这是特定应用的趋势判断,不是已实现的全球服务器CPU/加速器出货比例。

C50 · Arm · 2027财年第一季度股东信 ↗2026-07-29 · 公司披露

Neoverse累计出货核心超过15亿,最近5亿核心用了约9个月;这是累计核心数,不是芯片颗数或2026年年度出货。

C51 · VecAI · AI科研云端应用交流(匿名归纳)2026-09-21 · 专家访谈观点

受访者认为当前科研智能体以文献、代码和局部专业工具调用为主,跨软件自动闭环仍在早期;仅供采用阶段判断,不能外推其样本比例。

C52 · VecAI · 企业数据平台与工具接口交流(匿名归纳)2026-09 · 专家访谈观点

自然语言驱动的反复数据查询可能增加数据库CPU负载;原生工具接口也可能降低逐屏浏览器执行核时。需扣除对原有查询的替代。

C53 · VecAI · 服务器供需与交期交流(匿名归纳)2026-09-14 · 专家访谈观点

受访者观察到部分型号交期较前期改善;集中备货、订单回落与供给恢复均可能影响交期,不能据单次访问推断全行业宽松。

C54 · VecAI · 云端个人智能体部署交流(匿名归纳)2026-09-28 · 专家访谈观点

受访者举例以与GPU分离的云虚拟机运行个人智能体,单实例配置2个虚拟CPU及8GB内存,通过接口调用模型;只是个别配置,虚拟CPU配额并非独占物理核心。

C59 · AMD · 2026年第二季度业绩电话会 ↗2026-08 · 公司管理层表态

管理层称2026年服务器CPU供给紧张、2027年自身供应情况料优于2026年;并将智能体沙箱视为2030年市场增长的重要组成。

C60 · VecAI · CPU一线调研2026-09-29 · 专家调研

受访者观察到高核心数CPU结构性紧张、部分高端型号延长交期;所述18A-P投产与特定季度产量未经公司公告确认。

C64 · AMD · EPYC Venice生产爬坡 ↗2026-05-21 · 公司公告

下一代EPYC Venice在台积电N2进入生产爬坡阶段;最终可交付量还取决于良率、封装和产品分配。

C65 · Tom’s Hardware · Muse云电脑配置观察 ↗2026-09-25 · 科技媒体调查

媒体根据用户在Muse云电脑内获取的环境信息报道单实例约2虚拟CPU、8GB内存;这并非Meta公布的统一规格,虚拟CPU配额也不能直接等同独占物理核。

C66 · OpenAI · dots常驻智能体 ↗2026-09-30 · 公司产品说明

每个dot有独立云电脑和浏览器,能周期工作、通过连接工具跨应用跟进并委派子智能体;常驻不等于CPU始终满载。

C70 · 福邦证券 · ABF载板供需预测2026(资料核对) · 行业研究预测

原始表格2025年缺口-6%,2026—2028年预测+1%、+26%、+46%;是全行业高阶载板测算,不等于CPU缺货率。

C71 · 高盛 · 台湾ABF载板研究更新2026-09-16 · 机构研究预测

2026年下半年、2027、2028短缺率分别估计14%、34%、51%;与福邦全年缺口口径未明确一致,不拼接成一条序列。

C75 · AMD · Advancing AI 2026投资者圆桌逐字稿 ↗2026-07-23 · 公司管理层表态

管理层认可2030年服务器CPU可服务市场超过2000亿美元,强调智能体沙箱是长期增量;属于公司机会判断而非本报告芯片收入预测。

C76 · AMD · 第五代EPYC官方定价与技术资料 ↗2024—2026 · 公司产品资料

高核心数EPYC的公开千颗起批价格达万美元级,属于目录价,不能当大客户成交均价;核心数与平均价值量的弹性为研究假设。

C78 · TrendForce · 2026年服务器CPU价格跟踪 ↗2026-04-22 · 行业研究

部分服务器CPU自2026年3月以来报价上涨10%—20%,并报道后续涨价计划;局部型号与计划涨幅不能直接当全球已实现成交均价。

N02 · 陈立武称英特尔目前只能满足约一半客户所需CPU ↗2026-09-20 · 媒体报道

在9月14日Splunk .conf26与思科高管公开对谈中,英特尔CEO陈立武表示,CPU需求高到公司目前只能提供客户所需的大约50%,并称多位企业CEO因供货不足来电。报道未给出统计时段、订单定义或服务器与个人电脑的拆分。

N03 · AMD预计自身2027年服务器CPU供应好于2026年 ↗2026-08-04 · 公司财报

AMD二季度电话会称服务器CPU供应链目前紧张,部分需求超出此前预测;公司预计2027年自身供应情况好于2026年,并认为可支持服务器CPU收入增长。这是AMD的供应判断,不能直接代表全球市场已经转为宽松。

N04 · AMD将2030年服务器CPU市场预期上调至约2200亿美元 ↗2026-08-04 · 公司财报

AMD在7月活动提出、8月二季度电话会重申2030年服务器CPU市场约2200亿美元的预期;公司称二季度EPYC销售额同比增长超过70%,预计自身服务器CPU收入2026年下半年同比增长超过80%、2027年全年超过70%。未来市场和收入均为公司预期。

N06 · 路透:国内部分服务器CPU年内涨价超过40%,客户商谈长期锁量 ↗2026-07-23 · 媒体报道

路透援引两名知情人士称,英特尔与AMD正同中国服务器客户讨论通常约一年、部分更长的采购量承诺,价格不锁定;其中一名信源称,中国部分服务器CPU自2026年初涨价超过40%。这不是所有型号的普遍涨幅,也不是两家公司确认的合同总量。

N09 · TrendForce预计2027年服务器CPU供给改善 ↗2026-07-21 · 行业机构原始研究

TrendForce预计2026年全球服务器整机出货同比增长17%;并判断服务器CPU与内存供给在2027年逐步改善,有望释放部分先前受约束的整机需求。该判断是行业预测,不代表短缺已结束。

N13 · 台积电新增N3工厂将在2027—2028年分批量产 ↗2026-04-16 · 公司财报

台积电一季度电话会预计台南新增N3厂于2027年上半年量产、亚利桑那第二厂于2027年下半年量产、日本第二厂于2028年量产,并转换部分N5设备支持N3。新增投片仍须在CPU、GPU和专用芯片之间分配。